Kavramlar: matematiksiz
Bu sayfa videolarda geçen terimleri, depodaki dosyalarla eşleştirerek anlatır. Teknik terimleri İngilizce asıllarıyla kullanıyoruz; Türkçe karşılıkları ilk geçtikleri yerde parantez içinde. Sırayla okursan sonraki bölümlerdeki her tablo anlam kazanır.
Reinforcement learning (RL)
Bölüm başlığı “Reinforcement learning (RL)”Reinforcement learning (pekiştirmeli öğrenme) şu demek: robota “şöyle yürü” diye bir hareket yazmıyoruz. Ona yalnız bir puan, yani reward veriyoruz ve deneme yanılmayla puanı artıran hareketleri bulmasını bekliyoruz.
| Terim | Ördekte karşılığı |
|---|---|
| Environment (ortam) | MuJoCo’daki sanal ördek + zemin + yerçekimi. Dosya: Open_Duck_Playground’daki joystick.py. |
| Observation (gözlem) | Ördeğin her step’te “gördüğü” 101 sayı: IMU’dan dönüş hızı ve ivme, komut (ilerleme/dönme hızı ve kafa hedefleri), 14 eklemin açısı ve hızı, son üç action’ı ve motor hedefleri, iki ayağın yere değip değmediği, reference motion’daki fazı. |
| Action (eylem) | 14 motorun hedef açısı: her bacakta 5, boyun ve kafada 4. |
| Step (adım) | 0,02 sn. Ördek saniyede 50 kez karar verir. |
| Episode (bölüm, deneme) | Bir deneme. Ördek düşünce ya da 20 sn dolunca biter, baştan başlar. |
| Policy (politika) | Observation’ı alıp action üreten küçük bir neural network (sinir ağı). Eğitilen şey bu. |
| Reward (ödül) | Her step’te verilen puan: birkaç terimin ağırlıklı toplamı. |
Resmî reward: 7 terim
Bölüm başlığı “Resmî reward: 7 terim”Open Duck’ın yürüme environment’ında reward şu 7 parçadan oluşur (joystick.py, reward_config.scales):
| Terim | Ağırlık | Ne ödüllendirilir / cezalandırılır |
|---|---|---|
tracking_lin_vel |
2,5 | İstenen hızda ilerlemek |
tracking_ang_vel |
6,0 | İstenen hızda dönmek |
alive |
20,0 | Düşmeden kalmak |
imitation |
1,0 | Reference motion’ı taklit etmek |
torques |
−0,001 | Motorları zorlamak (ceza) |
action_rate |
−0,5 | Ani, titrek hareket (ceza) |
stand_still |
−0,2 | Komut “dur” iken kıpırdamak (ceza) |
2. bölümde bu ağırlıkları bozunca ne olduğunu görüyoruz.
Imitation reward
Bölüm başlığı “Imitation reward”Sıfırdan yalnız “ileri git” reward’ıyla ördek çok garip yollar bulabilir. Open Duck bunu Disney’in BDX makalesindeki fikirle çözer: bir reference motion (referans yürüyüş) üretilir (parametrik bir yürüyüş motoru, polynomial_coefficients.pkl) ve ördeğin eklemleri ona ne kadar benzerse o kadar puan alır. Buna imitation reward (taklit ödülü) denir. Ördek yine kendisi öğrenir; reference motion yalnızca “neye benzemesi gerektiğini” söyler.
PPO ve paralel ördekler
Bölüm başlığı “PPO ve paralel ördekler”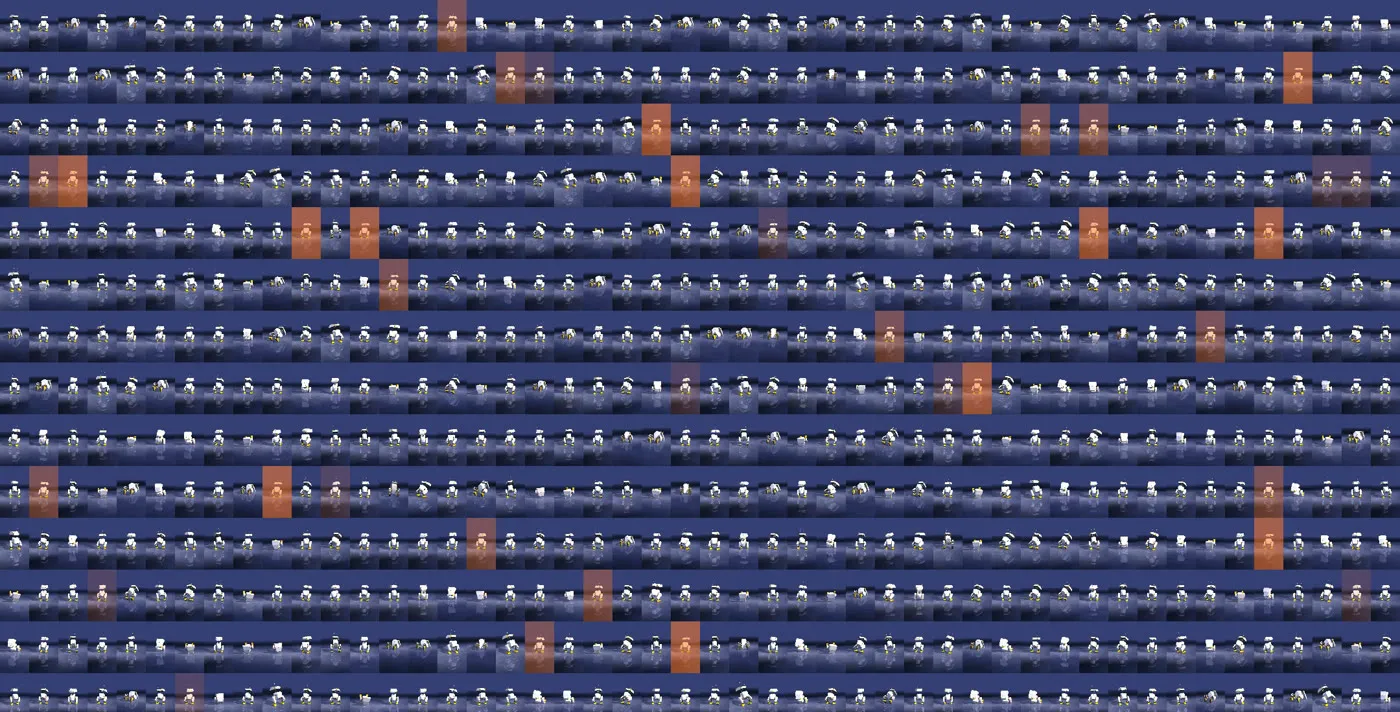
Temsilî: 0 adımdaki policy’nin 9 gürültülü kaydı 1.536 hücrede tekrar ediliyor. Turuncu = ördek düştü, episode bitti, baştan başlıyor.
PPO (Proximal Policy Optimization), policy’yi güncelleyen algoritma. Kabaca: ördekleri bir süre oynat, hangi hareketlerin beklenenden fazla puan getirdiğine bak, policy’yi o yöne küçük bir adımla it, tekrarla. “Küçük” kısmı önemli; büyük adımlar öğrenileni bozar.
Tek ördekle bu çok yavaş olurdu. Bu yüzden aynı anda 1.536 ördek (6 sanal cihaz × 256 parallel environment) simüle ediyoruz. Hepsi aynı policy’yi kullanır; her biri farklı rastgele durumda olduğu için PPO bir seferde çok çeşitli deneyim görür. “72,4 M step”, tüm ördeklerin toplam step sayısı.
MuJoCo, MJX, JAX
Bölüm başlığı “MuJoCo, MJX, JAX”- MuJoCo: fizik motoru. Kütle, sürtünme, temas, motorlar.
- MJX: MuJoCo’nun JAX ile yazılmış hâli. Binlerce ördeği aynı anda, tek bir dev hesap olarak çalıştırabilir.
- JAX: Google’ın sayısal hesap kütüphanesi. Kodu derleyip (XLA) işlemcide ya da GPU’da hızlı çalıştırır.
- Brax: PPO’nun JAX ile yazılmış hâli. Bizim eğitim döngümüz bu.
Domain randomization
Bölüm başlığı “Domain randomization”Simülasyon gerçeğin kusursuz kopyası değil. Policy tek bir mükemmel dünyaya ezber yapmasın diye, her paralel ortamın dünyası eğitim başında biraz farklı çekilir; buna domain randomization (alan rastgeleleştirme) denir. Resmî eğitimde değişenler (playground/common/randomize.py):
- zemin sürtünmesi: 0,5–1,0 (kodda var ama yanlış geom’a yazılıyor, zemin 0,6’da kalıyor: 3. bölüm)
- tüm parçaların kütlesi: ×0,9–1,1; gövdeye ±0,1 kg
- gövdenin ağırlık merkezi: ±5 cm
- motor sertliği (kp): ×0,9–1,1; eklem sürtünmesi ×0,9–1,1
- eklemlerin sıfır noktası: ±0,03 rad
- ayrıca: action ve IMU gecikmesi (0–2 step, her adımda), observation noise (gözlem gürültüsü), rastgele itmeler
Değiştirilmeyen önemli bir şey var: motorun verebileceği en büyük tork. 3. bölüm tam bunu inceliyor.
Checkpoint, ONNX, warm start
Bölüm başlığı “Checkpoint, ONNX, warm start”- Checkpoint: eğitimin belli bir anındaki policy’nin kaydı.
ckpt_068413440= 68.413.440. step’teki ördek. .pkl: Brax’ın ağırlıkları (eğitime devam etmek için)..onnx: aynı policy, her yerde çalışan standart formatta (değerlendirme, gerçek robot).- Warm start (sıcak başlangıç): yeni bir eğitime sıfırdan değil, bir checkpoint’ten başlamak. 2. ve 3. bölümlerin hepsi 68,4 M’den başlar.
İki tür test
Bölüm başlığı “İki tür test”| Deterministic test | 9 gürültülü ördek | |
|---|---|---|
| Betik | eval_checkpoint.py |
eval_grid.py |
| Nasıl | Policy’nin en olası action’ı, her seferinde aynı sonuç | Eğitimdeki gibi exploration noise (keşif gürültüsü) ile, 9 farklı seed |
| Ne söyler | “Bu ördek temiz koşulda ne yapıyor?” | “Ne kadar sağlam? Kaçı düşüyor?” |
İkisi de 5 sn, düz zemin, itme yok, komut 0,15 m/s ileri. “Düştü” = gövde 60°’den fazla eğildi (eğitimdeki 90° kuralından katı).
Sim2real
Bölüm başlığı “Sim2real”Sim2real (simulation to real): simülasyonda öğrenilen policy’yi gerçek robota taşımak. Aradaki her fark (motor gücü, gecikme, kütle, sürtünme) robotun gerçekte farklı davranmasına yol açar. Domain randomization bu farkı kapatmanın en yaygın yolu; motoru doğru ölçmek, yani system identification (sistem tanımlama) diğeri. Open Duck ekibi motorlarını BAM ile ölçüyor.