20 · Pixel'den masaya: homography ve depth back-projection
| Bölüm | 5 · Perception ve estimation |
| Çalışma türü | CPU · Mac ya da Colab CPU |
| Önkoşul | 19 |
| Önce öğren | Linear Systems · Monocular Depth & Geometry Estimation |
| Süre | ~45 dk |
| Kod | experiments/20-pixels-to-table/experiment.py |
| Durum | ✅ tam |
Bu derste yap
Her adımı yapınca işaretle. Yalnız bu tarayıcıda saklanır.
Bir pixel bir ışındır; onu noktaya çevirmek için bir bilgi daha gerekir: bilinen bir düzlem (homography) ya da ölçülmüş bir depth.
Problem
Bölüm başlığı “Problem”Ders 21’deki detector “küp (u, v) pixel’inde” diyecek. Kolun ise base frame’inde (x, y, z) bilgisine ihtiyacı var. Bir pixel yalnızca kamera merkezinden çıkan bir ışını belirler; o ışın üzerindeki her nokta aynı pixel’e düşer. Noktayı seçmenin iki standart yolu var: nesnenin masa düzleminde olduğunu varsayıp homography kullanmak ya da depth görüntüsünü okuyup back-projection yapmak. İkisinde de ince hata yapmak kolaydır: homography düzlemin üstündeki her şey için sessizce yanlıştır, depth görüntüsü de değerlerinin ne anlama geldiğini yanlış okursan sessizce yanlıştır.
Okumadan önce · 2 soru. Önce tahmin et; nedenini ders anlatıyor.
1. MuJoCo’nun depth Renderer’ının döndürdüğü metreleri her pixel’in ışını boyunca mesafe gibi kullanıyorsun. Ne olur?
- Hiçbir şey; pinhole kamerada ikisi aynıdır.
- Noktalar 138,0 mm’ye kadar hatalı çıkar, en çok görüntü köşelerinde; çünkü değerler optik eksen boyunca depth.
- Her nokta near-clip mesafesi kadar, 5,0 mm kayar.
Neden: Render edilen depth z-depth ile en fazla 0,008 mm farklı. olarak kullanınca back-projection en fazla 0,009 mm hatalı; ışın uzunluğu sanınca medyan 45,8 mm, en fazla 138,0 mm.
2. Detector küpün (u, v) pixel’inde olduğunu söylüyor. Bu pixel tek başına küpün yeri hakkında ne söyler?
- Yalnızca kamera merkezinden çıkan bir ışın; üzerindeki noktayı seçmek için bilinen bir düzlem ya da ölçülmüş bir depth gerekir.
- kamera matrisi bilindiğinde tam 3D konumunu.
- Kamera kalibre edildiği sürece masadaki konumunu.
Neden: Işın üzerindeki her nokta aynı pixel’e düşer. İki yol bir bilgi ekler - masa düzlemi (homography) ya da depth görüntüsü (back-projection); homography 100 mm’lik bir kutunun üstünde 88,5 mm hatalı.
Ana fikir
Bölüm başlığı “Ana fikir”Sade anlatımla
Bölüm başlığı “Sade anlatımla”Bir pixel sana mesafe değil, yön söyler: lense tutulmuş, o pixel’in içinden nişan alan bir lazer işaretleyici düşün; ışın boyunca her nokta aynı pixel’e düşer. 3D bir nokta için bir bilgi daha gerekir; yaygın iki tanesi var.
- Işının nerede durduğu. Depth görüntüsü her pixel için yüzeyin ne kadar uzakta olduğunu saklar. Işın boyunca o kadar yürürsen noktayı bulursun. Bu back-projection’dır, ders 19’daki kamera fonksiyonunun tersi.
- Nesnenin hangi yüzeyde durduğu. Nesne masanın üstündeyse nokta, ışının masa düzlemine çarptığı yerdir. Homography bu durum için bir kısayoldur: birkaç işaretli noktadan uydurulan, görüntüden masaya giden 3×3’lük bir dönüşüm; hiç kamera modeli gerektirmez, bir hava fotoğrafını bilinen işaret noktalarıyla haritaya oturtmak gibi. Düz yatan şeyler için tamdır, yukarı çıkıntı yapan her şey için yanlıştır.
İkisi de robotun ve kameranın frame’lerde anlaşmasını ister: masa ve robot base aynı dünya frame’ini paylaşır, kameranın bu frame’deki pozu calibration’dan gelir.
Frame’ler ve iki yol
Bölüm başlığı “Frame’ler ve iki yol”flowchart TD
B["dünya = robot base frame'i<br/>masa z = 0 düzlemi"]
B -- "kamera pozu R_wc, c<br/>(calibration, ders 19)" --> C["kamera frame'i<br/>x sağa, y aşağı, z ileri"]
C -- "intrinsics K<br/>(ders 19)" --> I["görüntü: pixel (u, v)"]
I -- "yol 1: depth Z<br/>X_w = c + R_wc · Z · K⁻¹ [u, v, 1]" --> B
I -- "yol 2: homography H<br/>(4+ masa marker'ı)" --> T["masa noktası (x, y)<br/>yalnızca z = 0 ise geçerli"]
T --> B
İki yol, kod olarak
Bölüm başlığı “İki yol, kod olarak”X_w = c + R_wc @ (Z * np.linalg.inv(K) @ [u, v, 1.0]) # route 1: Z = depth along the optical axisx, y, w = H @ [u, v, 1.0] # route 2: homography pixel -> table ...x, y = x / w, y / w # ... divide the scale out; z assumed 0| Parça | Formül |
|---|---|
| Back-projection, optik eksen boyunca | |
| Sensor bunun yerine ışın uzunluğu raporlarsa | |
| Homography (masa düzlemi) | |
| Depth buffer’dan metreye (klasik / ters) | / |
pixel, kamera matrisi, kameranın optik ekseni boyunca ölçülen depth, ışın boyunca Öklid mesafesi, ve noktanın kamera ve dünya koordinatları, sütunları dünyada ifade edilmiş kamera eksenleri olan rotation, kamera merkezinin dünyadaki konumu, 3×3’lük homography, “ölçek dışında eşit”, ham depth buffer değeri, ise near ve far kırpma mesafeleridir.
| Yöntem | Gerekenler | Geçerli olduğu yer | Bozulduğu durum |
|---|---|---|---|
| Homography | 4+ bilinen masa noktası | düzlemdeki noktalar | nesnenin yüksekliği var, masa düz değil |
| Depth back-projection | , kamera pozu, depth görüntüsü | görünen her yüzey | depth yanlış okunmuş, depth noise’u, eksik depth |
Matematik ayrıntısı: z-depth ile ışın uzunluğu, MuJoCo depth buffer'ı ve homography'nin kaynağı
Z-depth ile ışın uzunluğu. ‘nin üçüncü bileşeni 1’dir; onu ile çarpmak, kamera ‘si tam olarak olan bir nokta verir. Back-projection’ın optik eksen boyunca depth istemesinin sebebi budur. bunun yerine ışın boyunca Öklid mesafesi olsaydı, önce ‘ye bölmen gerekirdi; ikisi yalnızca görüntü merkezinde örtüşür, en çok köşelerde ayrışır.
Ders 19’un extrinsics’inden. Ders 19 yazdı. için çözersek ; yani ve kamera merkezi .
MuJoCo’dan depth. GPU metre değil, doğrusal olmayan bir z-buffer değeri saklar. Near/far kırpma mesafeleri ve ile (extent = modelin genel boyutu; znear ve zfar varsayılan olarak 0,01 ve 50, MuJoCo XML · visual/map), klasik bir OpenGL buffer’ı verir. MuJoCo 3.17’nin Python Renderer’ı ters çevrilmiş bir buffer okur (near’da 1, far’da 0), ‘yi float64’te uygular ve float32 metre döndürür (renderer.py, tag 3.17.0); Sıfırdan yaz, Adım 2 aynısını mjr_readPixels’ten yapıyor. Dokümantasyon, near düzlemini fazla yakın koymanın depth çözünürlüğüne mal olduğu konusunda uyarır.
Homography. Bir düzlemdeki noktalar görüntüye 3×3’lük bir projektif dönüşümle gider. Masa için ders 19’daki projeksiyon ‘nin üçüncü sütununu kaybeder: , yani ile . ‘nin 8 serbestlik derecesi var (9 eleman, ölçek dışında tanımlı); 4 nokta çifti (hiçbir üçü aynı doğru üzerinde olmayan) onu belirler, daha fazlası least-squares uyumu verir (cv2.findHomography, method 0; outlier’lar için RANSAC/LMEDS/RHO, OpenCV calib3d). ya da depth gerekmez, yalnızca bilinen masa noktaları. Bedeli: formül yalnızca için doğrudur.
Düzlemin üstündeki hata. Dikeyle açısı yapan bir ışın üzerinde yüksekliğindeki bir nokta, o ışının ‘a ulaştığı yere, yatayda daha öteye eşlenir. Hata tek bir ışın boyunca ‘de doğrusaldır ve eğik ışınlarda daha büyüktür.
Daha derine: Linear Systems, Monocular Depth & Geometry Estimation; düzlemin indüklediği homography’ler ve back-projection için Hartley & Zisserman (kitap sayfası).
Sıfırdan yaz
Bölüm başlığı “Sıfırdan yaz”Şimdi pixel’den masaya giden iki yolu da NumPy ile yazacaksın: ışınlar ve back-projection, depth buffer dönüşümü ve masa homography’si; ardından Deney’in sweep’lerini kendi kodunla tekrar koşturacaksın. Sahne, 300 masa pixel’i, marker’lar ve rastgele noise Deney script’inden geliyor (aynı seed); MuJoCo render ediyor, OpenCV hakemlik ediyor.
Adımları kendi dosyana yaz ve her adımdan sonra çalıştır. Bitmiş fonksiyonlar physai/vision.py içinde; uv run python experiments/20-pixels-to-table/build.py beş adımı kontrolleriyle birlikte koşturur (çıktı build_output.txt dosyasında).
Adım 1 · Işınlar ve back-projection
Bölüm başlığı “Adım 1 · Işınlar ve back-projection”Bir pixel’in ışını, dünyaya çevrilmiş ‘dir. Kamera ‘si 1 olacak şekilde ölçeklenince, onun boyunca kadar yürümek depth’ine götürür; bir düzlemle kesiştirmek için yalnızca kamera yüksekliği gerekir.
def pixel_rays(uv, K, R_wc): """World-frame directions of the rays through pixels uv (N, 2), scaled so each has camera z = 1.""" p = np.c_[uv, np.ones(len(uv))] @ np.linalg.inv(K).T # [x/z, y/z, 1] in the camera frame return p @ R_wc.T # rotate into the worlddef back_project(uv, Z, K, R_wc, c): """World points seen at pixels uv with depth Z (N,) measured along the optical axis, not along the ray.""" return c + Z[:, None] * pixel_rays(uv, K, R_wc)def ray_plane(uv, K, R_wc, c, z0=0.0): """Where the pixel rays meet the horizontal plane z = z0; also returns the z-depth of each hit.""" r = pixel_rays(uv, K, R_wc) s = (z0 - c[2]) / r[:, 2] # how far to walk along each ray return c + s[:, None] * r, sNoisy pixel’ler pixel merkezlerinin arasına düşer; bu yüzden depth okuması interpolasyon yapar:
def bilinear(img, uv): """Sample img at sub-pixel positions uv (N, 2) from the four nearest pixels (pixel centres on integers).""" u0 = np.clip(np.floor(uv[:, 0]).astype(int), 0, img.shape[1] - 2) v0 = np.clip(np.floor(uv[:, 1]).astype(int), 0, img.shape[0] - 2) a, b = uv[:, 0] - u0, uv[:, 1] - v0 # weights inside the pixel square return ((1 - a) * (1 - b) * img[v0, u0] + a * (1 - b) * img[v0, u0 + 1] + (1 - a) * b * img[v0 + 1, u0] + a * b * img[v0 + 1, u0 + 1])== Step 1. Rays, the table plane and depth back-projection (camera 0.6 m, 300 table pixels) ==max |ray_plane - Experiment's hit_plane| = 0.0e+00 mrendered depth vs z-depth s: median 0.001 mm, max 0.008 mmrendered depth vs ray length: median 45.8 mm, max 138.0 mmback_project, depth used as Z: median 0.001 mm, max 0.009 mmback_project, depth misused as length: median 45.8 mm, max 138.0 mmsub-pixel lookup: max |bilinear - cv2.remap| = 3.5e-08 mBunlar Deney’in ilk tablosu, bu kez senin kodundan: MuJoCo’nun depth’i her ışın-düzlem kesişiminin z-depth’iyle 0,008 mm içinde aynı; onu ışın uzunluğu saymak 138,0 mm’ye kadar hataya mal oluyor. Senin bilinear okuman cv2.remap ile 3,5e-08 m içinde aynı.
Adım 2 · Ham depth buffer
Bölüm başlığı “Adım 2 · Ham depth buffer”Renderer bir dönüşümü gizliyor. Aynı karenin depth buffer’ını mjr_readPixels ile kendin oku ve çevir:
def linearize_depth(d, near, far): """Reversed-Z depth-buffer value d (1 at near, 0 at far) to metres along the optical axis.""" return near * far / (near + d * (far - near))== Step 2. The raw depth buffer ==near 5.0 mm, far 24.9 m; raw values 0.005052 .. 0.008911 (1 = near, 0 = far)max |linearize_depth(raw) - Renderer| = 0.0012 mmimage centre: Renderer 0.6924 m, ours 0.6924 m, conventional formula 0.0050 mHam değerler metre değil: görüşteki her şey için 0,005 ile 0,009 arası, çünkü buffer kabaca near/depth saklıyor (near düzleminde 1, far düzleminde 0). Senin dönüşümün Renderer’la 0,0012 mm içinde aynı; bu, sabitlerinin float32 yuvarlaması. Klasik buffer için ders kitabı formülü, bu ters buffer’a uygulanınca masayı lensten 5,0 mm uzağa, yani near düzlemine koyuyor. Buffer ayrıca alttaki satırdan başlıyor (OpenGL); flipud bu yüzden.
Adım 3 · Masa homography’si
Bölüm başlığı “Adım 3 · Masa homography’si”düzlemi için kamera modeli homography’yi doğrudan verir (Matematik ayrıntısı):
def plane_homography(K, R_wc, c): """Pixel -> table (x, y) homography of the plane z = 0, from the camera model: (K [r1 r2 t])^-1.""" R = R_wc.T # world -> camera, as in lesson 19 t = -R @ c H = np.linalg.inv(K @ np.c_[R[:, 0], R[:, 1], t]) return H / H[2, 2]def apply_homography(H, p): """Map points p (N, 2) with H and divide out the scale.""" q = np.c_[p, np.ones(len(p))] @ H.T return q[:, :2] / q[:, 2:3]Bunun yerine onu marker’lardan ders 19’daki homography_dlt ile uydur; kaynak pixel’ler, hedef masa noktaları:
== Step 3. The table homography: from the camera model and from markers ==plane_homography vs ray_plane on the 300 pixels: max 2.8e-16 m 4 markers: exact pixels, max |H_fit - H_cam| on the table 1.0e-15 m; 1 px noise, ours vs cv2: median 0.000 mm, max 0.000 mm12 markers: exact pixels, max |H_fit - H_cam| on the table 1.2e-15 m; 1 px noise, ours vs cv2: median 0.181 mm, max 1.380 mmHatasız marker pixel’lerinden 4 ya da 12 marker, kamera modelinin homography’sini 1e-15 m içinde veriyor. 1 px noise’la 4 nokta ‘yi yine tam belirliyor, dolayısıyla sonucun OpenCV’ninkiyle aynı. 12 noktada ikisi medyan 0,181 mm farklı: senin DLT’n cebirsel bir hatayı küçültüyor, findHomography sonucu reprojection error üzerinde iyileştiriyor.
Adım 4 · Noise sweep’i senin kodunla
Bölüm başlığı “Adım 4 · Noise sweep’i senin kodunla”Deney’in döngüsü, seed’i ve pixel’leri; cv2.findHomography yerine homography_dlt, cv2.remap yerine bilinear:
== Step 4. The pixel-noise sweep with your functions (Experiment seed and loop, 200 pixels x 50 trials) == noise px H from 4 pts H from 12 pts depth back-proj (median mm) 0 0.00 0.00 0.00 0.5 2.15 1.76 0.81 1 4.33 3.33 1.60 2 8.90 7.59 3.21 4 17.08 13.92 6.374 noktalı ve depth sütunları Deney tablosuyla aynı (1 px’te 4,33 ve 1,60 mm). 12 noktalı sütun Adım 3’teki iyileştirme farkı yüzünden biraz farklı (1 px’te 3,27 yerine 3,33 mm, 4 px’te 14,17 yerine 13,92 mm); sıralama ve sonuç değişmiyor.
Adım 5 · Boz, senin fonksiyonlarınla
Bölüm başlığı “Adım 5 · Boz, senin fonksiyonlarınla”== Step 5. Break it: the top face of each box (no pixel noise) == box height mm homography mm depth back-proj mm ray_plane at z = 0.6 h mm 10 4.7 0.00 1.9 20 10.8 0.00 4.3 50 36.7 0.00 14.7 100 88.5 0.01 35.4Homography hataları Boz tablosu. Son sütun Kendini dene 3’ü çalıştırarak cevaplıyor: her ışını tahmin edilen 0,6 yüksekliğiyle (50 mm’lik kutu için 30 mm) kesiştirmek 14,7 mm bırakıyor, homography hatasının %40’ı; çünkü tek bir ışın boyunca yatay kayma yükseklikte doğrusal.
Elinde kalan
Bölüm başlığı “Elinde kalan”physai.vision artık pixel_rays, back_project, ray_plane, linearize_depth, bilinear, plane_homography ve apply_homography de içeriyor. Ders 21, tespit edilen bir blob’u aynı back-projection ile masa noktasına çeviriyor. tests/test_20_pixels_to_table.py bunları tam geometriye, SciPy’a ve OpenCV’ye sabitliyor; bir şey değiştirdikten sonra uv run pytest tests/test_20_pixels_to_table.py çalıştır.
Kütüphaneyle kullan
Bölüm başlığı “Kütüphaneyle kullan”MuJoCo metrik depth render eder; OpenCV homography’leri uydurur ve uygular.
r = mujoco.Renderer(m, 480, 640)r.enable_depth_rendering()r.update_scene(d, camera="cam")depth = r.render() # (480, 640) float32, metres along the optical axisH, inliers = cv2.findHomography(marker_px, marker_xy, 0) # 0 = all points; cv2.RANSAC for outliersxy = cv2.perspectiveTransform(px.reshape(-1, 1, 2), H).reshape(-1, 2) # needs shape (N, 1, 2)| Parça | Bu ders / physai | OpenCV | MuJoCo |
|---|---|---|---|
| ‘yi uydur | homography_dlt(src, dst) | findHomography(srcPoints, dstPoints, method), (H, mask) döndürür | — |
| ‘yi uygula | apply_homography(H, p), (N, 2) | perspectiveTransform(src, H), src (N, 1, 2) | — |
| metrik depth | optik eksen boyunca | — | enable_depth_rendering() ile Renderer |
| ham depth buffer | linearize_depth(d, near, far) | — | mjr_readPixels; near, far = znear, zfar × stat.extent |
Kaynaklar: OpenCV calib3d, MuJoCo renderer, 3.17.0, MuJoCo XML · visual/map; (N, 1, 2) şartı, OpenCV 5.0.0’ın burada dayattığı şey.
Tuzaklar:
- Range değil, z-depth. Depth’i birim ışınla değil ile çarp (Adım 1: 138,0 mm’ye kadar).
- Ham buffer ters ve baş aşağı. Ters formülü kullan ve satırları çevir (Adım 2: klasik formül 5,0 mm veriyor).
- ‘nin yönü.
findHomography(src, dst)src’yi dst’ye götürür. Burada src pixel’ler, dst masa noktaları; yer değiştirirsen masadan görüntüye giden dönüşümü alırsın ve onun tersi gerekir.
Yazdıktan sonra · 2 soru.
1. Sıfırdan yaz, Adım 2’de ders kitabı depth formülü ‘yi MuJoCo’nun ham buffer’ına uyguluyorsun. Masayı nereye koyar?
- Doğru depth’e, 0,6924 m’ye; çünkü iki formül örtüşür.
- Far düzlemine, 24,9 m uzağa.
- Lensten yaklaşık 5,0 mm uzağa, near düzlemine; çünkü buffer ters (near’da 1, far’da 0).
Neden: Adım 2 görüntü merkezini yazıyor - Renderer 0,6924 m, senin ters formülün 0,6924 m, klasik formül 0,0050 m. Ham değerler yalnızca 0,005 ile 0,009 arası, kabaca near/depth.
2. Sıfırdan yaz, Adım 4’te 4 noktalı homography’n Deney’i birebir tekrarlıyor (1 px’te 4,33 mm), ama 12 noktalı sütun 3,27 yerine 3,33 mm veriyor. Neden?
- DLT’nde yalnızca daha fazla noktayla ortaya çıkan bir hata var.
- Dört nokta ‘yi tam belirler; 12 noktada senin DLT’n cebirsel bir hatayı küçültürken
findHomographyreprojection error üzerinde iyileştirir. - İki çalıştırmada random seed farklı.
Neden: Adım 3, 4 marker’la bizimkinin ve OpenCV’nin 0,000 mm içinde aynı olduğunu, 12 marker’la medyan 0,181 mm farklı olduğunu gösteriyor. Sweep’in sıralaması ve sonucu değişmiyor.
Kurulum. MuJoCo sahnesi: gri masa düzlemi, 10/20/50/100 mm yüksekliğinde dört kutu, dikeyden 30° eğik, (0,25, 0, 0)‘a bakan 640×480’lik bir kamera (fovy = 50). Bir pixel’in ground truth’u, ışınının gördüğü yüzeyle tam kesişimidir. Homography marker’ları: 20 × 20 cm’lik bir bölgedeki 4 ya da 12 bilinen masa noktası, pixel’leri Gauss noise’uyla bozulmuş (tespit hatası); test pixel’leri görüş boyunca rastgele masa pixel’leri, onlar da bozulmuş. Depth back-projection, render edilen depth’i bilinear okumayla kullanır.
r.enable_depth_rendering(); depth = r.render() # metres along the optical axisP = c + depth_at(uv)[:, None] * (np.c_[uv, ones] @ np.linalg.inv(K).T @ R_wc.T)H, _ = cv2.findHomography(marker_px, marker_xy, 0) # pixel -> table (x, y)Tahmin. Simülasyonda depth tamdır, dolayısıyla hatası pixel noise’u çarpı pixel izdüşümü (bir pixel’in masadaki boyu) olmalı. Homography kendi uydurma hatasını eklemeli ve düzlemin üstünde bozulmalı.
Çalıştır: uv run python experiments/20-pixels-to-table/experiment.py (MuJoCo 3.17.0, OpenCV 5.0.0, NumPy 2.5.4, Apple M5, deterministic). Bu Mac’te MuJoCo, stderr’e ARB_clip_control’ün olmadığını ve depth doğruluğunun sınırlı olacağını yazan bir uyarı basar; aşağıdaki ölçümler buna rağmen elde edilenlerdir.
Depth görüntüsünde ne var (kamera 0,6 m’de; extent 0,497 m, yani near 5,0 mm, far 24,9 m; 300 masa pixel’i):
| Karşılaştırma | Medyan | En büyük |
|---|---|---|
| render edilen depth - optik eksen boyunca z-depth | 0,001 mm | 0,008 mm |
| render edilen depth - Öklid ışın uzunluğu | 45,8 mm | 138,0 mm |
| back-projection, depth olarak | 0,001 mm | 0,009 mm |
| back-projection, depth yanlışlıkla ışın uzunluğu olarak | 45,8 mm | 138,0 mm |
Dönen değerler z-depth’tir. Onları ışın uzunluğu saymak görüntü köşelerinde 138,0 mm’ye kadar hataya mal olur.
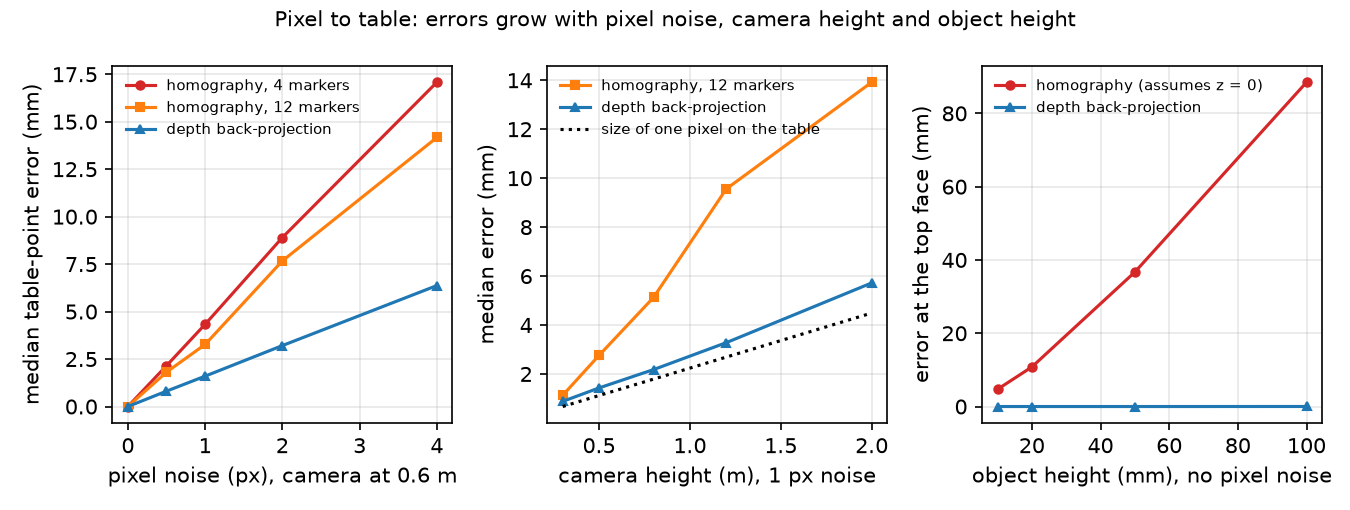
Pixel noise’u (kamera 0,6 m; 200 test pixel’i × 50 deneme, mm cinsinden medyan hata):
| Noise (px) | 4 noktadan H | 12 noktadan H | Depth back-projection |
|---|---|---|---|
| 0 | 0,00 | 0,00 | 0,00 |
| 0,5 | 2,15 | 1,81 | 0,81 |
| 1 | 4,33 | 3,27 | 1,60 |
| 2 | 8,90 | 7,67 | 3,21 |
| 4 | 17,08 | 14,17 | 6,37 |
Kamera yüksekliği (1 px noise, 12 noktalı H):
| Yükseklik (m) | Hedefte pixel başına mm | Homography (mm) | Depth back-projection (mm) |
|---|---|---|---|
| 0,3 | 0,67 | 1,13 | 0,88 |
| 0,5 | 1,12 | 2,76 | 1,43 |
| 0,8 | 1,79 | 5,13 | 2,18 |
| 1,2 | 2,69 | 9,56 | 3,28 |
| 2,0 | 4,49 | 13,92 | 5,72 |
Gözlem.
- Tüm hatalar pixel noise’unda doğrusal. Depth back-projection hatası, hedefteki pixel izdüşümünün 1,2–1,3 katı: depth kusursuzken hata bütçesinin tamamı pixel noise’udur.
- Homography eşit noise’ta yaklaşık 3 kata kadar daha kötü: 8 parametresi yalnızca 20 × 20 cm’lik bir bölgeyi kaplayan noisy marker’lardan uyduruluyor ve test pixel’leri bunun dışına extrapolate ediliyor. 12 marker 4’ü yener (1 px’te 3,27’ye karşı 4,33 mm).
- Yükseklikle depth hatası izdüşüm gibi büyür (0,88 → 5,72 mm, izdüşüm 0,67 → 4,49 mm), homography hatası daha hızlı (1,13 → 13,92 mm): kamera yükseldikçe sabit marker bölgesi daha az pixel kaplar.
- Simüle edilen depth noise’suzdur; gerçek depth sensor’leri kendi noise’unu ekler, dolayısıyla depth sütunu bir alt sınırdır.
Her kutunun üst yüzünün merkezini gören pixel’i sorgula (pixel noise’u yok):
| Kutu yüksekliği (mm) | Homography xy hatası (mm) | Depth back-projection hatası (mm) |
|---|---|---|
| 10 | 4,7 | 0,00 |
| 20 | 10,8 | 0,00 |
| 50 | 36,7 | 0,00 |
| 100 | 88,5 | 0,01 |
Homography her pixel’i, ışınının ‘a çarptığı yere götürür; yüksekliğindeki bir nokta ışın boyunca kameradan uzağa kayar: hata ile ve ışının ne kadar eğik olduğuyla büyür. 10 mm’lik bir nesne bile 4,7 mm’ye mal olur. Çözüm: yükseklik biliniyorsa ışını ile kesiştir (bu yalnızca ‘yi değil, ‘yı ve pozu gerektirir) ya da depth kullan.
Gerçek robotta
Bölüm başlığı “Gerçek robotta”- Masa üstü bir SO-101 kurulumunda, ölçülmüş konumlara yapıştırılan 4–12 marker’dan bir homography hızlı bir calibration’dır ve düz, ince nesneler için yeterlidir. Marker konumlarını göz kararı değil, robot base frame’inde ölç. Gerçek kolda henüz ölçülmedi.
- Gerçek depth kameraları geçerli depth’i olmayan pixel’ler döndürür; driver’ının bunları nasıl işaretlediğine bak ve ortalamadan önce maskele. Sensor’ünün z-depth mi range mi raporladığını dokümanından kontrol et; hiçbir gerçek depth kamerasını test etmedik.
- Kamera pozu , extrinsic calibration’dan (base’te bilinen bir konumdaki board) ya da bilek kamerası için hand-eye calibration’dan gelir (ders 19); hatası back-project edilen her noktaya doğrudan eklenir.
Kendini dene
Bölüm başlığı “Kendini dene”Hızlı kontrol · 2 soru. Bir cevaba tıkla.
1. Masada uydurulan bir homography, 50 mm’lik bir kutunun üstünü gerçek yerinden 36,7 mm uzağa eşliyor. Neden?
- Her pixel’i ışınının ‘a çarptığı yere eşler; yükseltilmiş bir nokta ışın boyunca kameradan uzağa kayar.
- ‘yi uydurmak için dört marker çok az.
- Kutunun üst yüzü daha koyu, bu yüzden pixel yanlış tespit ediliyor.
Neden: Boz bölümünde pixel noise’u yok - hata yalnızca düzlem varsayımından geliyor ve yükseklikle büyüyor (10 mm’de 4,7 mm, 100 mm’de 88,5 mm). Depth back-projection 0,00–0,01 mm’de kalıyor.
2. Kusursuz simüle depth ve 1 px pixel noise’u ile kamerayı 0,3’ten 2,0 m’ye çıkarmak back-projection hatasını 0,88’den 5,72 mm’ye büyütüyor. Bunu ne belirliyor?
- Depth buffer kameradan uzakta çözünürlük kaybediyor.
- Homography marker’ları daha az pixel kaplıyor.
- Bir pixel’in masadaki izdüşümü; 0,67’den 4,49 mm’ye büyüyor.
Neden: Depth hatası hedefteki pixel izdüşümünün 1,2–1,3 katı - depth kusursuzken hata bütçesinin tamamı pixel noise’u. Marker bölgesi ise homography’nin neden daha hızlı büyüdüğünü açıklıyor (1,13 → 13,92 mm).
- Kolay. neden en az 4 nokta çifti ister?
- Orta. 0,6 m’de ve 1 px noise’ta depth back-projection 1,60 mm veriyor. Gerçek robotta bu simülasyonun dışarıda bıraktığı iki hata kaynağını say.
- Zor. “Bilinen yükseklik” back-projection’ını uygula: pixel ışınını ile kesiştir ve Boz tablosunu tekrar çalıştır. 50 mm’lik kutu için mm varsayarsan ne kadar hata alırsın?
Cevaplar
Bölüm başlığı “Cevaplar”- ölçek dışında tanımlıdır: 9 eleman eksi 1 = 8 bilinmeyen; her nokta çifti 2 denklem verir.
- Depth sensor noise’u ve ile kamera pozundaki calibration hatası (ayrıca hareket eden robotta rolling shutter ve zamanlama kaymaları).
- Doğru ile ışın gerçek noktaya çarpar. Tek bir ışın boyunca yatay kayma yükseklikte doğrusaldır ve homography durumudur; dolayısıyla 50 mm’lik kutu için 30 mm mm verir; Sıfırdan yaz, Adım 5 bunu çalıştırıyor: 14,7 mm.
Akılda kalanlar ve kaynaklar
Bölüm başlığı “Akılda kalanlar ve kaynaklar”mujoco.Rendererdepth’i optik eksen boyunca metrik z-depth’tir (burada en fazla 0,008 mm sapma); onu ışın uzunluğu saymak 138,0 mm’ye kadar hataya mal olur.- Homography: intrinsics gerekmez ama yalnızca düzlemde geçerlidir; 10 mm nesne yüksekliği bile 4,7 mm’ye mal olur.
- İki yöntem de pixel noise’u ve pixel izdüşümüyle doğrusal ölçeklenir; kameraları yakına yerleştir ve 4’ten fazla marker kullan.
Sıradaki: ders 21, manipulation için object perception.
Kaynaklar:
- MuJoCo XML reference · visual/map znear, zfar: model extent’inin kesri olarak kırpma düzlemleri; yakın near düzlemi için çözünürlük uyarısı.
- MuJoCo
rendering/classic/renderer.py, 3.17.0: ters Z okuma ve metreye dönüşüm. - OpenCV calib3d:
findHomographyyöntemleri. - R. Hartley, A. Zisserman, Multiple View Geometry in Computer Vision, 2. baskı, Cambridge University Press, 2004 (kitap sayfası): düzlemin indüklediği homography’ler ve back-projection.
- Yukarıdaki tüm sayılar:
experiment.py, çıktıoutput.txt; Sıfırdan yaz:build.py,build_output.txt.