35 · Reward tasarımı ve reward hacking
| Bölüm | 8 · Robotlar için reinforcement learning |
| Çalışma türü | CPU · Mac ya da Colab CPU |
| Önkoşul | 33 |
| Önce öğren | MDPs, States, Actions & Rewards |
| Süre | ~60 dk |
| Kod | experiments/35-reward-design/experiment.py |
| Durum | ✅ tam |
Bu derste yap
Her adımı yapınca işaretle. Yalnız bu tarayıcıda saklanır.
Agent kastettiğiniz görevi değil, yazdığınız reward’u optimize eder. Her terim ve bir episode’un bitebileceği her yol, yazdığınızın parçasıdır.
Problem
Bölüm başlığı “Problem”Go2 training config’i ağırlığı sıfır olmayan on reward terimini toplar; tracking_lin_vel = 1.0’dan action_rate = -0.01 ve torques = -0.0002’ye kadar. Ve yalnızca bir agent’ın reward’ları nasıl istismar ettiği yüzünden var olan bir satır taşır: only_positive_rewards = True # if true negative total rewards are clipped at zero (avoids early termination problems) (legged_robot_config.py, go2_config.py). Bu ders SO-101 uzanmasında, sabit bir PPO ve bütçeyle reward şekillerini karşılaştırıyor, bilerek bir reward hack’i üretiyor (yazılan reward’da yüksek puan alıp görevi yapmayan bir policy) ve bir yumuşaklık cezasını sweep ediyor.
Okumadan önce · 2 soru. Önce tahmin et; nedenini ders anlatıyor.
1. Reward pozitif yakınlık terimi ve episode cm olduğu anda bitiyor. Eğitilen kol ne öğrendi?
- Her hedefe olabildiğince hızlı ulaşmayı.
- Hedeften yaklaşık 3 cm uzakta park edip reward toplamaya devam etmeyi, çünkü topa girmek gelecekteki tüm ödemeleri bitirir.
- Shaping terimi iki kez ödesin diye hedefin etrafında salınmayı.
Neden: B bölümü: 95/300 başarı; termination olmadan çalıştırılınca aynı policy medyan 30,8 mm uzakta bitiyor. Yazılı return’ü (22,67), her hedefe ulaşan scripted IK’yı (2,28) geçiyor.
2. Bir episode’un her adımı bir ceza (negatif ödül) getiriyor ve düşmek episode’u bitiriyor. Ajan ne öğrenebilir?
- Erken düşmeyi, çünkü episode’u bitirmek cezaları durdurur.
- Mümkün olduğunca uzun ayakta kalmayı, çünkü düşmek her zaman kötüdür.
- Farklı bir şey değil; termination return’ü etkilemez.
Neden: Terminal state’ten sonra her ödül 0’dır; adım başına ise bitirmek bir kazançtır. Go2 config’i negatif toplamları tam da bunun için sıfırda kırpıyor, “avoids early termination problems”.
Ana fikir
Bölüm başlığı “Ana fikir”Sade anlatımla
Bölüm başlığı “Sade anlatımla”Reward bir metriktir ve RL onu hiç sağduyu kullanmadan optimize eder. Satır başına para öderseniz uzun kod alırsınız. Bir kola hedefe yakın olduğu için para öder ve oyunu vardığı anda bitirirseniz, kol hemen dışarıda beklemeyi öğrenir; çünkü varmak ödemeleri durdurur.
Dört tür yapı taşınız var. Sparse bir reward yalnızca başarıda öder: kesindir ama başta sessizdir; tek uçtan uca testi henüz hiç geçmeyen bir test paketi gibi. Dense bir reward her adımda yaklaştığı için biraz öder: bilgilendiricidir ama bir vekildir. Shaping ipuçları ekler; güvenli türü (potential-based) ilerleme için öder ve geri çekilmede bunu geri alır; böylece ileri geri gitmek, orijinal reward’un ödemeyeceği hiçbir şey kazandırmaz. Düzenleyiciler sarsıntılı ya da pahalı hareket için küçük cezalardır; başarıyı yumuşaklıkla takas ederler.
Bir episode’un nasıl bittiği de reward’un parçasıdır: bitişten sonra gelecekteki her reward sıfırdır. Adım başına reward pozitifse bitirmek bir kayıptır ve agent bundan kaçınır; negatifse bitirmek bir kazançtır ve agent onu arar.
Termination teşviki nerede tersine çevirir
Bölüm başlığı “Termination teşviki nerede tersine çevirir”flowchart TD
S["bir adımdan sonraki durum"] --> T{"episode burada<br/>bitiyor mu?"}
T -- "hayır" --> R["reward topla:<br/>görev + shaping − cezalar"]
R --> S
T -- "evet" --> Z["gelecekteki her reward 0"]
Z --> Q{"adım başına<br/>reward'un işareti"}
Q -- "pozitif" --> H["bitirmek kayıp:<br/>hedefin yakınında bekle"]
Q -- "negatif" --> E["bitirmek kazanç:<br/>içeri koş ya da erken düş"]
Shaping ve termination, kod olarak
Bölüm başlığı “Shaping ve termination, kod olarak”# Potential-based shaping: F = gamma * Phi(s') - Phi(s), with Phi = -20 * distancedef shaping(dist, dist_prev, gamma=0.95): return gamma * (-20 * dist) - (-20 * dist_prev) # > 0 when closer; also 20*(1-gamma)*dist when standing still
# It cannot be farmed: summed along any trajectory it telescopes to the two endpoints,# sum_t gamma^t * F_t = gamma^T * Phi(s_T) - Phi(s_0)
# What ending the episode costs: the discounted value of staying foreverdef value_of_staying(r_per_step, gamma=0.95): return r_per_step / (1 - gamma) # ending forfeits this: a relief if r < 0, a loss if r > 0| Terim | Örnek (uzanma, metre cinsinden mesafe) | Rolü |
|---|---|---|
| sparse görev | başarının tam olarak ne olduğunu söyler; başarı bulunana kadar hiç gradient vermez | |
| dense görev | her adımda hedefi gösterir; “iyi”yi bir vekille tanımlar | |
| potential-based shaping | optimal policy’yi değiştirmeden yönlendirme ekler | |
| düzenleyiciler | , | görev performansını yumuşaklık ve enerjiyle takas eder |
gripper ile hedef arasındaki mesafe, koşul sağlanınca 1, aksi hâlde 0, durumun herhangi bir fonksiyonu (potansiyel), ve bir adımdan önceki ve sonraki durumlar, discount, bir ceza ağırlığı, action ve eklem torkudur.
Matematik ayrıntısı: potential-based shaping neden güvenli, termination neden önemli
Potential-based shaping. Ng, Harada ve Russell, herhangi bir potansiyeli için eklemenin optimal policy’yi değiştirmediğini ve MDP hakkında başka bilgi yoksa bu biçimin o garanti için gerekli de olduğunu gösterdi (ICML 1999, s. 278–287). Bir trajectory boyunca terimler teleskop gibi sadeleşir, ; bu yalnızca uç noktalara bağlı bir bonustur, yani shaping neyin optimal olduğunu değil, ne kadar hızlı öğrenildiğini değiştirir. PPO discount’u ile kullanıyoruz.
Termination. Bir durumda sonsuza kadar kalıp adım başına toplayabilen bir policy kazanırdı. Terminal bir duruma girmek bunu 0 ile değiştirir. için bu, agent’ın kaçınmayı öğrendiği bir kayıptır; için aramayı öğrendiği bir kazanç. Locomotion’da düşmek episode’u bitirir; bu yüzden çoğu negatif cezalardan oluşan bir toplam erken düşmeyi cazip kılar; Go2 config’i toplamı “early termination problems” için sıfırda keser. Ters durum bizim hack’imizdir.
Daha derine: MDPs, States, Actions & Rewards; Ng, Harada, Russell, ICML 1999 (yukarıdaki bağlantı).
Sıfırdan yaz
Bölüm başlığı “Sıfırdan yaz”Şimdi reward terimlerini yazacak, shaping’in bir SO-101 episode’unda teleskop gibi sadeleştiğini kontrol edecek, küçük bir koridoru tam olarak çözecek ve termination hack’ine sayı koyacaksın. Hiçbir şey eğitilmiyor: Adım 2, 4 ve 5 scripted IK controller’lı reach görevini, Adım 3 tablo tabanlı bir oyuncak problemi kullanıyor; yaklaşık 2 s.
Fonksiyonlar physai/rl.py içinde; uv run python experiments/35-reward-design/build.py beş adımın hepsini koşturur (çıktı build_output.txt dosyasında).
Adım 1 · Reward terimleri
Bölüm başlığı “Adım 1 · Reward terimleri”def sparse_reward(d, radius=0.02): """1 inside the success ball, 0 elsewhere.""" return float(d < radius)def closeness_reward(d, scale=0.05): """Positive at every step, 1 at the target: the reward behind the termination hack.""" return 1.0 - np.tanh(d / scale)def potential_shaping(phi, phi_prev, gamma): """Potential-based shaping term F = gamma * Phi(s') - Phi(s) (Ng, Harada, Russell 1999).""" return gamma * phi - phi_prevdef action_rate_penalty(a, a_prev, w): """Smoothness regularizer: -w * ||a_t - a_(t-1)||^2.""" return -w * float(np.sum((np.asarray(a) - np.asarray(a_prev)) ** 2))Deney’deki gibi birleştir (ör. sparse artı potential_shaping(-20 * d, -20 * d_prev, 0.95)) ve 1000 rastgele adımda Deney’in reward fonksiyonlarıyla karşılaştır:
== Step 1. Reward terms vs the Experiment's reward functions, 1000 random steps ==sparse 0.0e+00, pbrs 4.4e-16, closeness 0.0e+00, action rate 0.0e+00closeness at d = 0, 2, 5, 30.8 mm: 1.000, 0.620, 0.238, 0.452Closeness reward’u 2 cm yarıçapta 0,620, hack yapan policy’nin park ettiği 30,8 mm’de 0,452.
Adım 2 · Shaping teleskop gibi sadeleşir
Bölüm başlığı “Adım 2 · Shaping teleskop gibi sadeleşir”def discounted_sum(rewards, gamma): """sum_t gamma^t r_t.""" return float(np.sum(np.asarray(rewards) * gamma ** np.arange(len(rewards))))Bir episode boyunca yalnız shaping terimini topla, bir kez scripted IK ile, bir kez rastgele action’larla:
== Step 2. Shaping telescopes: sum_t gamma^t F_t = gamma^T Phi(s_T) - Phi(s_0), Phi = -20 d == scripted IK: d 55.2 -> 0.2 mm, sum gamma^t F_t = +1.104336, gamma^T Phi_T - Phi_0 = +1.104336, diff 2.2e-16random actions: d 55.2 -> 147.0 mm, sum gamma^t F_t = +1.055855, gamma^T Phi_T - Phi_0 = +1.055855, diff 4.4e-16loop 10 cm -> 5 cm -> 10 cm, gamma 1.00: shaping earned +0.0000 (= (gamma^2 - 1) Phi = +0.0000)loop 10 cm -> 5 cm -> 10 cm, gamma 0.95: shaping earned +0.1950 (= (gamma^2 - 1) Phi = +0.1950)İki toplam da yuvarlama düzeyinde ‘a eşit: bir trajectory’nin kazandığı shaping yalnızca uç noktalarına bağlı. 10 cm → 5 cm → 10 cm döngüsü ile 0, ile ise +0,1950 kazandırıyor; formüldeki . Bu bir açık değil: aynı uç noktalar arasındaki her yol aynı discount’lu bonusu kazanır, dolayısıyla döngü orijinal reward’un söylediği kadar değerlidir. Adım 3 bunu optimal policy’de kontrol ediyor.
Adım 3 · Hangi reward’lar optimal policy’yi korur
Bölüm başlığı “Adım 3 · Hangi reward’lar optimal policy’yi korur”1 cm aralıklı 11 hücrelik bir koridor, hedef 10. hücrede (oraya girmek episode’u bitirir), action’lar sol, dur, sağ, . Value iteration bunu tam olarak çözer:
def value_iteration(next_state, reward, terminal, gamma, iters=2000):    """Optimal values and greedy actions of a deterministic tabular MDP.
    next_state[s, a] and reward[s, a] describe one step; entering a terminal state ends the episode (value 0 after).    """    V = np.zeros(next_state.shape[0])    for _ in range(iters):        Q = reward + gamma * np.where(terminal[next_state], 0.0, V[next_state])        V = Q.max(1)    return V, Q.argmax(1)
== Step 3. A corridor of 11 cells, 1 cm apart; cell 10 is the target and ends the episode ==reward greedy action in cells 0..9 value of cell 0sparse: 1 on arrival >>>>>>>>>> 0.630sparse + gamma Phi' - Phi >>>>>>>>>> 2.630sparse + 0.5 per step closer >>>>>>>>>< 6.768closeness 1 - tanh(d/5cm) >>>>>>>>>o 12.251(> right, < left, o stay)shaped - sparse values, cells 0..9: max |difference - (-Phi(s))| = 3.3e-16Sparse ve shaped reward’lar aynı policy’yi veriyor, her hücrede sağa; shaped değerler de Ng, Harada ve Russell’ın öngördüğü gibi sparse değerlerin eksiği (fark 3,3e-16). Eşit derecede makul görünen iki reward ise policy’yi değiştiriyor. Yaklaşılan her adım için 0,5 ödemek, geri almadan, 9. hücreyi sola adım attırıyor: ileri geri gitmek varmaktan fazla kazandırıyor. Termination’lı closeness reward’u 9. hücrede durduruyor, bir santimetre kala, sonsuza kadar: Deney B’nin hack’i, tam olarak çözülmüş hâli.
Adım 4 · Sayılarla termination hack’i
Bölüm başlığı “Adım 4 · Sayılarla termination hack’i”== Step 4. The termination hack in numbers ==scripted IK, closeness reward, ends on success: written return 2.28, mean length 10.1 stepsparking at 30.8 mm for 80 steps: 0.452 per step, written return 36.13; discounted value of parking forever r / (1 - gamma) = 9.03entering the ball pays at most 1.00 once, then nothingScripted controller her hedefe 10,1 adımda ulaşıyor ve 2,28 alıyor, Deney’deki sayı. 30,8 mm’de park etmek adım başına 0,452, 80 adımda 36,13, discount’lu değer olarak 9,03 ödüyor; varmak ise en fazla bir kez 1,00. Eğitilmiş policy’nin 22,67’si arada: episode’ların çoğunda park ediyor, hepsinde değil.
Adım 5 · Bir yumuşaklık cezası ne kadar büyük?
Bölüm başlığı “Adım 5 · Bir yumuşaklık cezası ne kadar büyük?”‘nin iki terimini scripted controller’ın episode’larında ölç:
== Step 5. Action-rate penalty vs the task term, scripted IK, 100 episodes ==per step: mean d = 11.9 mm, mean ||a_t - a_t-1||^2 = 0.0082w = 0.03: penalty / task term = 0.02w = 0.1 : penalty / task term = 0.07w = 0.3 : penalty / task term = 0.21w = 1.0 : penalty / task term = 0.68w = 3.0 : penalty / task term = 2.05Go2 config: action_rate = -0.01 times dt 0.02 s -> 0.0002 per stepBu action’lar için ceza, ‘te görev teriminin %2’si, 0,3’te %21’i, 1,0’da %68’i; Boz’daki başarı 0,1 ile 0,3 arasında çöküyor. IK’nın action’ları eğitilmiş policy’ninkiler değil, bu yüzden bu yalnızca ölçeği verir. Go2’nin action_rate = -0.01’i adım başına 0,0002 olur (0,02 s’lik periyotla çarpılarak).
Elinde kalan
Bölüm başlığı “Elinde kalan”physai.rl artık sparse_reward, closeness_reward, potential_shaping, action_rate_penalty, discounted_sum ve value_iteration’ı da içeriyor. Ders 36 bu türden terimlerden bir locomotion reward’u kuruyor. tests/test_35_reward_design.py teleskop sadeleşmesini ve 20 rastgele MDP’de potential-based shaping’in optimal policy’yi koruduğunu ve değerleri kadar kaydırdığını kontrol ediyor; uv run pytest tests/test_35_reward_design.py çalıştır.
Kütüphaneyle kullan
Bölüm başlığı “Kütüphaneyle kullan”Gymnasium reward’u environment’a bırakır; env’i düzenlemeden değiştirmek için onu sar. gymnasium.wrappers.TransformReward(env, func) her skaler reward’u dönüştürür (ölçekleme, kaydırma). Shaping state’e ihtiyaç duyar, bu yüzden bir wrapper’ın step’ine (ya da ReachEnv’in reward_fn’ine) öğrenenin ‘sıyla girer. Unitree’nin training kodu reward’u adlandırılmış terimlerin ağırlıklı toplamı olarak kurar, her ölçek policy periyoduyla çarpılır (legged_robot.py):
| Parça | Bu ders / physai | legged_gym |
|---|---|---|
| bir terim | info’nun bir fonksiyonu | scales.<name> ile ağırlıklandırılan bir _reward_<name> metodu |
| adım başına ağırlık | yazıldığı gibi | self.reward_scales[key] *= self.dt |
| action yumuşaklığı | action_rate_penalty: | _reward_action_rate: torch.sum(torch.square(self.last_actions - self.actions), dim=1) |
| pozitif kırpma | kullanılmıyor | only_positive_rewards: torch.clip(self.rew_buf[:], min=0.) |
| termination terimi | kullanılmıyor | _reward_termination: self.reset_buf * ~self.time_out_buf, kırpmadan sonra eklenir |
Son satır ders 32 ile 35’i bağlıyor: termination terimi time-out’larda değil gerçek termination’larda tetiklenir ve kırpmadan sonra eklenir; böylece bir termination cezası kırpmadan sağ çıkar.
Üç tuzak:
- Termination teşviki tersine çevirir. Pozitif adım reward’uyla bitirmek bir kayıptır (Adım 3: bir hücre kala), negatifle bir kazanç; terminal bir koşul eklemeden önce hangisini istediğine karar ver.
- Yanlış ile shaping potential-based değildir. ile , öğrenenin discount’lu return’ünde artık teleskop gibi sadeleşmez ve garanti gider.
- Ağırlıklar görecelidir. Bir ceza ağırlığı görev teriminin büyüklüğü olmadan hiçbir şey ifade etmez (Adım 5); kontrol hızı değişince
legged_gym’in adım başına ağırlıkları da değişir, çünküdtile çarpılırlar.
Yazdıktan sonra · 2 soru.
1. Sıfırdan yaz, Adım 3’te koridor hedefe her yaklaşma adımı için 0,5 ödüyor, uzaklaşınca geri almıyor. Optimal policy hedefin yanında ne yapar?
- Seyrek ödülde olduğu gibi hedefe girer.
- Sonsuza dek 9. hücrede kalır.
-
- hücrede sola adım atar, çünkü ileri geri gitmek varmaktan daha çok kazandırır.
Neden: Bu bonus potential-based değil, bu yüzden optimal policy’yi değiştiriyor (0. hücrenin değeri seyrek ödüldeki 0,630’a karşı 6,768). Potential-based shaping policy’yi korur ve değerleri kadar kaydırır (fark 3,3e-16).
2. Adım 2’de 10 cm → 5 cm → 10 cm döngüsü ile +0,1950 shaping kazandırıyor. Kol ileri geri giderek shaping terimini sömürebilir mi?
- Evet; döngü başına +0,1950 sınırsızca birikir.
- Hayır; aynı uç noktalar arasındaki her yol aynı indirgenmiş bonusu kazanır, , yani döngü orijinal ödülün söylediği kadar değerlidir.
- Yalnızca ile.
Neden: +0,1950 formüldeki ‘dir; gerçek episode’larda iki toplam da yuvarlama düzeyinde ‘a eşit ve koridorda shaped policy seyrek olanla aynı.
experiment.py ders 33’teki her şeyi sabit tutar (mutlak joint hedefleri, 50 Hz, PPO referans config’i, 300k adım, 3 seed × 100 evaluation episode’u) ve env’e verilen reward fonksiyonunu değiştirir.
Reward’lar Sıfırdan yaz’ın Adım 1 terimlerinden kurulur: sparse, sparse + shaping, closeness ve + action-rate cezası.
Tahmin edin: closeness reward’u ve gripper 2 cm’ye girdiği anda biten bir episode ile eğitilen kol ne yapacak?
MuJoCo 3.17.0, NumPy 2.5.4, PyTorch 2.14.1 (CPU), Apple Silicon Mac (Apple M5). Seed başına deterministik. Script’in tamamı (33 run, altısı paralel) yoğun yüklü bir makinede 1904 s sürdü. python experiment.py --only close+end,pbrs yalnızca o hücreleri üç seed’le eğitir; bu tekrar çalıştırma onların satırlarını aynen üretti. --quick yalnızca seed 0’ı eğitir: her satırın ilk “seed başına başarı” girdisini yeniden üretir, toplam sütunlarını değil.
A. Reward şekli (termination yok; başarı = 1,6 s’lik zaman sınırında 2 cm içinde):
| reward | seed başına başarı | toplam | Wilson %95 | medyan son mesafe |
|---|---|---|---|---|
| dense | 100 / 98 / 100 | 298/300 | %97,6–99,8 | 7,5 mm |
| sparse | 8 / 0 / 0 | 8/300 | %1,4–5,2 | 117,8 mm |
| sparse + , | 99 / 97 / 99 | 295/300 | %96,2–99,3 | 7,8 mm |
(Medyan son mesafe: üç seed üzerinden ortalama.) Sparse reward görevin dürüst tanımıdır ve başarısız olur: başlangıç policy’si nadiren 2 cm’ye yaklaşır (ders 32: rastgele action’lı 200 episode’un 1’i), bu yüzden training’in çoğunda her reward sıfırdır ve advantage’lar bilgi taşımaz. Potential-based bir terim öğrenmeyi dense reward düzeyine geri getirir (aralıklar örtüşüyor) ve hangi policy’nin optimal olduğunu değiştirmez (Sıfırdan yaz, Adım 3).
B. Reward hacking. Episode artık cm olduğu anda biter (terminated); “ulaştı”yı tanımlamanın doğal bir yolu gibi görünür. Reward pozitif closeness terimidir, :
| reward, termination | seed başına başarı | toplam | Wilson %95 | yazılan return | episode uzunluğu | medyan son mesafe |
|---|---|---|---|---|---|---|
| closeness, başarıda biter | 23 / 43 / 29 | 95/300 | %26,7–37,1 | 22,67 | 62,3 adım | 28,8 mm |
| , başarıda biter | 99 / 100 / 98 | 297/300 | %97,1–99,7 | −0,72 | 9,2 adım | 14,7 mm |
| closeness, termination yok | 98 / 100 / 100 | 298/300 | %97,6–99,8 | 64,00 | 80,0 adım | 5,1 mm |
İki kontrol ölçümü hack’i açık hâle getirir:
- Her hedefe ulaşan scripted IK controller, closeness-artı-termination reward’u altında yalnızca 2,28 yazılan return alır (Sıfırdan yaz, Adım 4). Hack yapan policy 22,67 alır: kendi amacında, görevi daha az yaparak doğru controller’ı yener.
- Termination olmadan çalıştırıldığında aynı hack yapan policy hedeften medyan 30,8 mm uzakta bitirir: gripper’ı yaklaşık 3 cm uzağa, başarı küresinin hemen dışına park eder ve episode’un geri kalanında adım başına kabaca 0,45 toplar.
Mekanizma diyagramdaki: küreye girmek gelecekteki tüm pozitif reward’u bitirir, bu yüzden agent yaklaşıp kısa durur (Sıfırdan yaz, Adım 3’teki koridor da aynısını yapıyor). 95 başarı, yine de kürenin içinde bittiği episode’lardır. Aynı termination kuralı negatif bir reward’la () ters teşvik verir: her adım maliyetli olduğu için agent içeri acele eder (ortalama 9,2 adım). Termination olmadan pozitif reward da çalışır (298/300). Hack kombinasyonda yaşar; bu yüzden kazara yazmak kolaydır.
Yumuşaklık cezaları, takasın bir uçuruma dönüştüğü yerdir. Action-rate teriminin ağırlığını sweep edin (Go2 config’i aynı terimi kullanır, action_rate = -0.01, legged_robot.py’de olarak hesaplanır; oradaki _prepare_reward_function her ağırlığı policy periyoduyla, 0,02 s ile çarpar, yani adım başına ağırlık ‘dir, hız takibi terimi ise adım başına en fazla ‘dir):
| seed başına başarı | toplam | Wilson %95 | medyan son mesafe (mm) | tork hızı (N·m/s) | güç (W) | |
|---|---|---|---|---|---|---|
| 0 | 100 / 98 / 100 | 298/300 | %97,6–99,8 | 7,5 | 1002 | 9,66 |
| 0,03 | 81 / 99 / 99 | 279/300 | %89,5–95,4 | 8,8 | 933 | 9,44 |
| 0,1 | 80 / 87 / 96 | 263/300 | %83,5–90,9 | 11,4 | 901 | 9,45 |
| 0,3 | 41 / 9 / 94 | 144/300 | %42,4–53,6 | 25,6 | 850 | 8,20 |
| 1,0 | 7 / 35 / 14 | 56/300 | %14,7–23,5 | 39,2 | 674 | 6,54 |
| 3,0 | 27 / 6 / 26 | 59/300 | %15,6–24,5 | 31,9 | 743 | 5,64 |
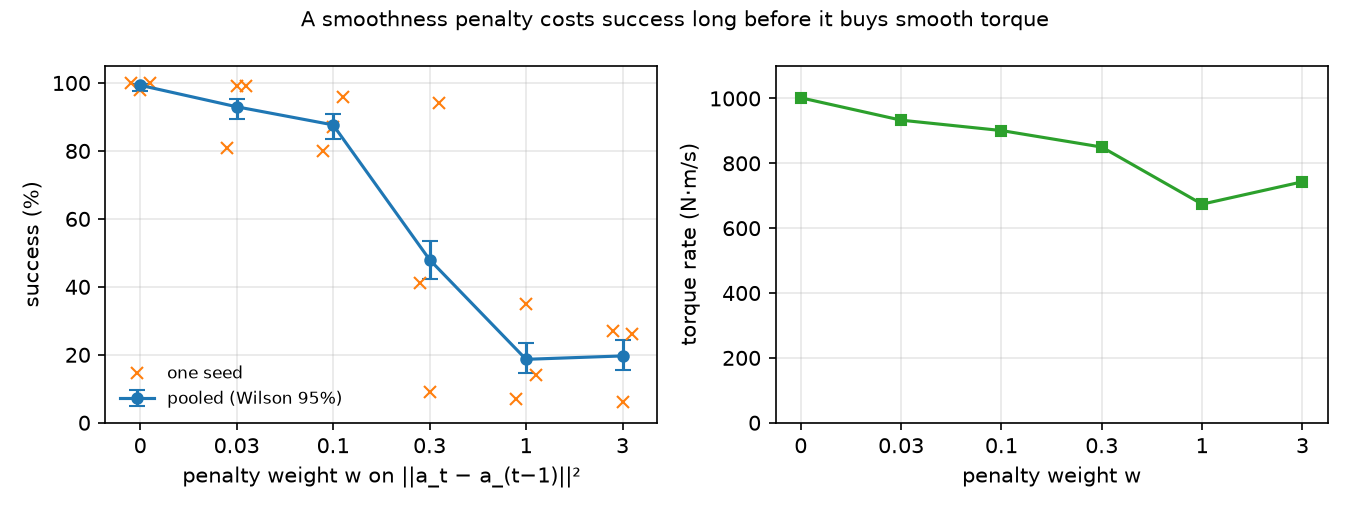
‘e kadar policy başarıdan 6 ila 12 yüzde puanı kaybeder (298/300’e karşı 279/300 ve 263/300) ve çok az yumuşaklık kazanır (tork hızı 1002 → 901 N·m/s). ‘ten itibaren başarı çöker ve seed’ler arasında büyük fark oluşur (100 üzerinden 9’a karşı 94): ceza artık mesafe teriminin hatırı sayılır bir payıdır (Sıfırdan yaz, Adım 5: ‘te scripted controller’ın action’ları için yaklaşık beşte bir). Güç düşer (9,66 → 5,64 W), büyük ölçüde kol daha az hareket ettiği için: medyan son mesafe 25,6–39,2 mm’ye çıkar. İki ders: bir düzenleyicinin ağırlığını görev terimine göre ayarlayın ve sert bir servoyla policy’nin hedeflerini yumuşatmak torku pek yumuşatmaz. Amaç yumuşak torksa, ‘yi büyütmeden önce arayüzü ya da gain’leri değiştirin (ders 34).
Gerçek robotta
Bölüm başlığı “Gerçek robotta”- Ceza ağırlıkları simülasyonda görev başarısını daha nazik hareketle takas eder; ölçülen tork hızı azalmasının gerçeğe taşınıp taşınmadığı gerçek actuator’e bağlıdır. SO-101’de ölçülmedi.
- Training için yazılan bir termination kuralı donanımda aynı zamanda bir güvenlik kuralıdır: gerçek robotta “episode biter”, bir denetleyicinin hareketi durdurması demektir (ders 15). Reward, bu durmayı policy’nin kendi başına aradığı ya da kaçındığı bir şey hâline getirmemelidir.
- Go2 config’inin ağırlıkları onun simülatörü ve PD gain’leri için ayarlandı; ikisinden birini değiştirirseniz başka bir anlam taşırlar.
Kendini dene
Bölüm başlığı “Kendini dene”Hızlı kontrol · 2 soru. Bir cevaba tıkla.
1. Sparse reward 8/300 verdi; ile eklemek 295/300 verdi. Bu terim optimal policy’yi neden değiştirmez?
- Duruma bakmadan her adımda aynı bonusu öder.
- Başarı koşulunu bir mesafe koşuluyla değiştirir.
- Herhangi bir trajectory boyunca toplandığında ‘a teleskoplanır; bu da yalnızca trajectory’nin nerede başlayıp bittiğine bağlıdır.
Neden: Ng, Harada ve Russell (Math details). Shaping ne kadar hızlı öğrendiğinizi değiştirir, neyin optimal olduğunu değil; A bölümü hızlanmayı gösteriyor.
2. ağırlıklı bir action-rate cezası 144/300 verdi (seed’ler 41 / 9 / 94), torque rate ise yalnızca 1002’den 850 N·m/s’ye düştü. Çıkarılacak ders ne?
- Ağırlığı görev teriminin ölçeğine göre seçin; servo sertse ve amaç yumuşak torque ise arayüzü ya da gain’leri değiştirin.
- Cezalar torque’u her zaman ağırlıklarıyla orantılı olarak yumuşatır, ‘yi daha da artırın.
- Seed’ler anlaşamıyor, demek ki cezanın hiçbir etkisi yok.
Neden: Boz tablosu: ‘e kadar başarı 263/300’e düşüyor, yumuşama az (901 N·m/s); 0,3’ten sonra çöküyor. Sert bir servonun hedeflerini yumuşatmak torque’unu pek yumuşatmaz.
- Kolay. Closeness reward’unda hedeften 3 cm uzağa park etmiş bir gripper adım başına ne kadar reward toplar, başarı küresine girdikten sonra ne toplar?
- Orta. Termination’ı kaldırmadan hack’i düzeltin: episode başarıyla bittiğinde bir terminal bonus ekleyin. Ulaşmayı, kalan ~60 adım boyunca havada beklemek kadar iyi yapan ‘yi tahmin edin, sonra üç seed eğitip ölçün.
- Zor. Action-rate cezasını env içinde fizik hızında hesaplanan bir tork hızı cezasıyla değiştirin ve sweep’i tekrarlayın. Kaybedilen başarı başına action-rate teriminden daha fazla yumuşaklık sağlıyor mu?
Cevaplar
Bölüm başlığı “Cevaplar”- Adım başına ; başarıdan sonra episode biter, sonraki her reward 0’dır.
- ~0,46 ile adım daha beklemek eder ve ‘ye yaklaşır (Sıfırdan yaz, Adım 4: 30,8 mm’de 9,03); bunun belirgin biçimde üstünde bir bonus teşviki ortadan kaldırır. Biz eğitmedik.
- Açık; çalıştırmadık.
Akılda kalanlar ve kaynaklar
Bölüm başlığı “Akılda kalanlar ve kaynaklar”- Sparse reward’lar görevi tam olarak tanımlar ama bütçe içinde 8/300 verdi; potential-based shaping optimal policy’yi değiştirmeden 295/300’ü geri getirdi.
- Termination artı pozitif adım reward’u ölçülmüş bir reward hack’idir: 95/300 başarı, ~3 cm uzağa park edilmiş gripper ve her hedefe ulaşan bir controller’ın (2,28) yaklaşık on katı yazılan return (22,67). Bir episode’un bitebileceği her yerde reward’un işaretini kontrol edin.
- Düzenleyici ağırlıklarında uçurum var: action-rate ağırlığı 0,1 12 yüzde puanına mal oldu (263/300), 0,3 başarıyı yarıya indirdi; ağırlıkları görev terimine göre ayarlayın ve gerçekte elde ettiğiniz yumuşaklığı ölçün.
Sıradaki: ders 36, legged locomotion ve massively parallel training.
Kaynaklar
- A. Y. Ng, D. Harada, S. Russell, “Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping”, ICML 1999, s. 278–287. mlanthology
unitree_rl_gym·legged_robot_config.py,go2_config.py,legged_robot.py(_reward_action_rate,_reward_torques) (BSD-3-Clause).- J. Schulman vd., “Proximal Policy Optimization Algorithms”, 2017. arXiv 1707.06347
- Gymnasium ·
EnvAPI (terminated ve truncated). - Kod:
experiment.py,output.txt; env ve PPO ders 32 ve ders 33’ten; şekilplot.pyile üretildi.