26 · Teleoperation, replay ve data collection
| Bölüm | 7 · Learning from demonstration |
| Çalışma türü | CPU · Mac ya da Colab CPU |
| Önkoşul | 16, 25 |
| Önce öğren | yok |
| Süre | ~45 dk |
| Kod | experiments/26-teleop-replay-data/experiment.py · notebook |
| Durum | ✅ tam |
Bu derste yap
Her adımı yapınca işaretle. Yalnız bu tarayıcıda saklanır.
Replay hareketi tekrarlar, görevi değil. Bir kayıt ancak robotun ne gördüğünü ne yaptığıyla eşleştirdiğinde işe yarar.
Problem
Bölüm başlığı “Problem”LeRobot kaydedilmiş bir episode’u kolda tekrar oynatan bir komutla gelir: lerobot-replay, dataset’teki kayıtlı action’ları robota frame frame gönderir; dokümantasyon bunu robotun action’larının tekrarlanabilirliğini test etmenin bir yolu olarak sunar (LeRobot · imitation learning on real robots). Follower bir pick’i kusursuz tekrarlayınca robotun görevi öğrendiğini düşünmek kolaydır. Öğrenmemiştir: replay, küpe hiç bakmayan sabit bir joint hedefleri listesidir. Bu ders, replay başarısız olmadan önce küpün ne kadar kayabileceğini ölçüyor, bunu bakan bir controller’la karşılaştırıyor ve 27–29. derslerin öğreneceği demonstration’ları kaydediyor.
Okumadan önce · 2 soru. Önce tahmin et; nedenini ders anlatıyor.
1. Replay için kaydedilmiş action’lar yeter. Bir demonstration dataset’i neden her action’ın yanında observation’ı da saklamalı?
- Observation’lar action’ları sıkıştırır, dosya küçülür.
- Replay’in kendisi frame’leri zamanlamak için onlara ihtiyaç duyar.
- Öğrenen, görülenden yapılana giden eşlemeyi ancak ikisi zamanda hizalı saklanırsa taklit edebilir; tek başına action’lar farklı bir başlangıç state’ine tepki veremez.
Neden: Matematik ayrıntısı, “Kaydın tutması gerekenler”; kaydımız frame başına 9 observation değeri ve 6 joint hedefi saklıyor, 120 episode’da 13680 frame (B kısmı).
2. Kaydedilmiş bir pick birebir tekrar oynatılıyor, ama küp artık kayıttaki yerinden 3 cm uzakta. Ne beklersin?
- Genellikle başarısız olur, çünkü replay küpe hiç bakmayan sabit bir joint hedefleri listesidir.
- Başarılı olur, çünkü follower kaydı kusursuz tekrarlar.
- Başarılı olur, çünkü servo’lar konum hatasını düzeltir.
Neden: Servo’lar yalnız kaydedilen joint hedeflerini izler. A kısmı, 3 cm satırı; replay 1/8, küp pozundan yeniden planlama 8/8.
Ana fikir
Bölüm başlığı “Ana fikir”Sade anlatımla
Bölüm başlığı “Sade anlatımla”Bir makro kaydedici tıklamalarını sabit ekran koordinatlarında saklar ve tekrar oynatır; bir pencereyi kaydır, makro boşluğa tıklar. Önce ekrana bakan, düğmeyi bulan, sonra tıklayan bir script bu kaymadan sağ çıkar. Replay makrodur. Hareket etmeden önce küpün yerini okuyan bir controller ise script’tir.
Teleoperation, robot kayıtlarının yapılma biçimidir: bir insan robotu bir leader kol üzerinden sürer (kolun elle hareket ettirilen hafif, pasif bir kopyası) ve gerçek kol (follower) onun joint açılarını kopyalar. Bakan insandır. Kayıttan sonradan öğrenebilmek için kayıt her anın iki yarısını da saklamalı: robotun ne gördüğünü (observation) ve ona ne yapmasının söylendiğini (action). Replay yalnız action’ları tutar, observation’ları çöpe atar.
Demonstration’dan policy’ye
Bölüm başlığı “Demonstration’dan policy’ye”flowchart TD
H["insan leader kolu hareket ettirir"] --> FW["follower onun joint'lerini kopyalar"]
FW --> REC["kayıt aracı frame başına<br/>(observation, action) saklar"]
REC --> DS["episode'lardan dataset<br/>(ders 27)"]
DS --> RP["replay: action'ları geri gönder,<br/>observation'ları yok say"]
DS --> TR["çiftler üzerinde policy eğit<br/>(ders 28)"]
TR --> EV["yeni küp konumlarında evaluate et<br/>(ders 25)"]
Open loop ve closed loop, kod olarak
Bölüm başlığı “Open loop ve closed loop, kod olarak”# Replay = macro recorder: a fixed list indexed by time; the cube never enters the loopdef replay(actions): for a in actions: # a = 6 joint targets recorded at one frame robot.apply(a) robot.step(1 / fps) # hold it for one frame (zero-order hold)
# Closed loop = a program that looks at the screen before every movedef run(policy, T): for t in range(T): o = robot.observe() # joints, jaw, cube position robot.apply(policy(o)) # decide from what is seen now robot.step(1 / fps)
# Recording a demonstration keeps both halves of each frameepisode = []for t in range(T): o = robot.observe() # what the robot sees a = leader.read_joints() # what the human commands robot.apply(a) robot.step(1 / fps) episode.append((o, a)) # the pair a policy will learn from| Mod | Formül |
|---|---|
| open loop (replay) | , sabit bir dizi |
| closed loop | |
| kaydedilmiş bir episode | artı bir görev metni |
| zero-order hold | için |
Burada adım ‘de gönderilen komut, o adımdaki observation (robot state’i, gerçek robotta artı görüntüler), bir observation’ı komuta eşleyen controller ya da policy, kaydedilen action ( anında gönderilen joint hedefleri), bir episode’daki frame sayısı, Hz cinsinden kayıt hızı ve sürekli zamandır. Bir frame’in tam olarak hangi observation’ı ve action’ı eşlediğini Sıfırdan yaz, Adım 1 gösteriyor.
Loop’u kim kapatıyor
Bölüm başlığı “Loop’u kim kapatıyor”| Mod | Loop’u kim kapatıyor | Kaymış küpe genelleşir mi? |
|---|---|---|
| Kaydın replay’i | kimse | yalnız grasp toleransı içinde |
| Algıdan yeniden planlama | planlayıcı (ölçülen küp pozu üzerinde IK) | evet, algı doğruysa |
| Leader–follower teleoperation | insan, leader kol üzerinden | evet, insan uyum sağlar |
| Öğrenilmiş policy | network | 28–29. derslerin ölçtüğü şey |
IK, inverse kinematics’tir: gripper’ı istenen bir poza götüren joint açıları (ders 10).
Matematik ayrıntısı: open loop, closed loop ve bir kaydın içermesi gerekenler
Tanımlar. Open-loop bir controller önceden hesaplanmış bir komut dizisini sonucu ölçmeden uygular. Closed-loop (feedback) bir controller ‘yi o anki observation’dan hesaplar (Lynch & Park, Modern Robotics, bölüm 11). Replay tüm görev boyunca open loop’tur. Ders 16’nın scripted pick’i görev seviyesinde closed loop’tur: küpün yerini okur, IK çözer ve algılanan bir çene koşulunu bekler. Servolar her zaman kendi pozisyon loop’larını çalıştırır; buradaki “open loop”, görev seviyesinde açık demektir.
Replay neden biraz da olsa tolere eder. Kaydedilen çene açıklığı küpten geniştir. Küple çene arasındaki boşluktan küçük bir kayma yine küpü çenelerin arasında bırakır; daha büyüğü bırakmaz. Tolerans gripper geometrisinin bir özelliğidir ve yöne göre değişir (Boz).
Kaydın tutması gerekenler. Teleoperation sırasında insan ‘yi gördüğünden hesaplar. Bir öğrenen bu eşlemeyi ancak dataset ‘yi ‘nin yanında, zamanda hizalı olarak saklıyorsa taklit edebilir. ‘yi replay etmek ‘yi ve onunla birlikte farklı bir başlangıç state’ine tepki verme şansını atar.
Zero-order hold. Frame’ler arasında son action sabit tutulur. Kayıt, ancak tutulan basamaklar hareketin en hızlı kısmına (burada çene rampası) göre kısa kaldıkça expert’in geçerli bir tarifidir; C kısmı 25 Hz’i kontrol ediyor.
Daha derine: Lynch & Park, Modern Robotics, bölüm 11; LeRobot, Imitation learning on real-world robots.
Sıfırdan yaz
Bölüm başlığı “Sıfırdan yaz”Şimdi bu dersin veri tarafını yazacaksın: bir kaydı (observation, action) frame’lerine bölmek, replay için frame’leri tutmak ve bir replay’i kurtaran en küçük closed loop, yani kaydedilen joint’leri gözlenen küp kaymasıyla ders 09’un Jacobian’ı üzerinden yeniden hedeflemek. Sahneler, kayıtlar ve başarı testi Deney’inki. Adımları kendi dosyana yaz ve her adımdan sonra çalıştır. Bitmiş fonksiyonlar physai/data.py içinde; uv run python experiments/26-teleop-replay-data/build.py beş adımı kontrolleriyle birlikte koşturur (çıktı build_output.txt dosyasında).
Adım 1 · Bir kaydı frame’lere böl
Bölüm başlığı “Adım 1 · Bir kaydı frame’lere böl”Scripted pick 500 Hz’de koşuyor; dataset her 20 fizik adımında bir frame tutuyor. . frame, başındaki observation’ı 40 ms’sinin sonundaki komutla eşler:
def to_frames(o0, obs_steps, act_steps, k): """Frames every k physics steps: frame j holds the observation at its start (o0 for j = 0, else the state after step j*k) and the command sent at the end of its k steps.""" n = len(act_steps) // k return np.vstack([o0, obs_steps[k - 1:(n - 1) * k:k]]), act_steps[k - 1:n * k:k]Ders 16’nın pick’ini episode 0’ın küp konumu için koştur ve B kısmının kaydettiğiyle karşılaştır:
== Step 1. A scripted demonstration cut into 25 Hz frames vs demos.npz, episode 0 == 2284 physics steps -> 114 frames | demos.npz episode 0: 114 frames max |obs - saved| = 1.2e-07 | max |action - saved| = 1.2e-07
Aynı 114 frame. 1,2e-07 tek bir float32 yuvarlama adımı (dosya float32 saklıyor).
Adım 2 · Zero-order hold
Bölüm başlığı “Adım 2 · Zero-order hold”Replay her fizik adımı için bir komut ister; bu yüzden her frame 20 adım tutulur:
def hold(frames, k): """Zero-order hold: repeat each frame's command for k physics steps.""" return np.repeat(frames, k, axis=0)A kısmının sabit zaman çizelgeli kaydına (500 Hz’de 2250 komut) uygula:
== Step 2. Zero-order hold of the part-A recording (fixed 4.5 s timeline, cube at (22, 0) cm) == 2250 commands -> 112 frames -> 2240 held commands largest gap between held and original command: arm 3.72 deg, jaw 9.22 deg replay of the held frames at the recorded spot: held
Tutulan bir frame sonraki 40 ms’yi önceden alır: bir kol joint’inde 3,72°‘ye, jaw rampasında 9,22°‘ye kadar önde. Kaydedilen noktada pick yine çalışıyor, C kısmındaki gibi.
Adım 3 · Kayma altında open-loop replay
Bölüm başlığı “Adım 3 · Kayma altında open-loop replay”Tutulan frame’leri küp 8 yönde 1, 2 ve 3 cm kaymışken oynat; başarı testi Deney’inki (küp ≥ 4 cm yukarıda, iki çene de üstünde), aralık ders 25’in wilson’ı:
== Step 3. Open-loop replay of the held frames, cube shifted in 8 directions == shift held Wilson 95% failures 1 cm 7/8 [0.53, 0.98] pushed 1 2 cm 2/8 [0.07, 0.59] one jaw 1, pushed 5 3 cm 1/8 [0.02, 0.47] missed 2, pushed 5
Deney’in 500 Hz’lik replay’i 7/8, 3/8 ve 1/8 almıştı. Tutulan sürüm 1 ve 3 cm’de aynı, 2 cm’de bir denemeyi kaybediyor (135°, yalnız bir çene yakalıyor): hold jaw rampasını 40 ms’ye kadar kaydırıyor.
Adım 4 · Jacobian ile yeniden hedefle
Bölüm başlığı “Adım 4 · Jacobian ile yeniden hedefle”kadar kaymış bir küp, aletin her frame’de kadar kaymasını ister. Birinci dereceden, bunu en az hareketle yapan joint değişimi, konum Jacobian’ının pseudo-inverse’ü çarpı :
def retarget(q_frames, jac_pos, shift): """Move a recorded joint trajectory so the tool point moves by `shift` (m) at every frame, to first order: q' = q + pinv(J_p(q)) shift, with J_p the 3 x n position Jacobian.""" return np.array([q + np.linalg.pinv(jac_pos(q)) @ shift for q in q_frames])Düzeltmeden sonra, gripper’ın küpte aşağıda olduğu frame’de alet noktası ne kadar sapıyor?
== Step 4. Re-target with the Jacobian: q’ = q + pinv(J_p(q)) shift, error of the tool point == shift 1 cm toward +y: tool point off by 0.28 mm shift 2 cm toward +y: tool point off by 1.10 mm shift 3 cm toward +y: tool point off by 2.48 mm shift 5 cm toward +y: tool point off by 6.89 mm
Hata kaymanın karesiyle büyüyor, birinci dereceden bir yöntemin imzası; Deney’in yeniden planlaması bunun yerine IK’yı tam çözüyor (0,18 mm).
Adım 5 · Yeniden hedeflenmiş frame’leri oynat
Bölüm başlığı “Adım 5 · Yeniden hedeflenmiş frame’leri oynat”Küp konumunu bir kez oku, bütün frame’leri yeniden hedefle, tut, oynat:
== Step 5. Replay of the re-targeted frames (cube position read once), same 24 shifts == shift held Wilson 95% failures 1 cm 8/8 [0.68, 1.00] 2 cm 8/8 [0.68, 1.00] 3 cm 8/8 [0.68, 1.00]
Replay’in 10/24’üne karşı 24/24: hareketten önce küpün tek bir gözlemi bütün farkı yaratıyor. Öğrenilmiş bir policy (ders 28) aynısını her frame’de kendi girdilerinden yapmak zorunda.
Elinde kalan
Bölüm başlığı “Elinde kalan”physai.data artık to_frames, hold ve retarget içeriyor; ders 27 dataset fonksiyonlarını aynı modüle ekliyor. tests/test_26_teleop_replay_data.py frame indekslemesini, hold’u ve retarget’ın ikinci dereceden kalıntısını kontrol ediyor; uv run pytest tests/test_26_teleop_replay_data.py çalıştır.
Kütüphaneyle kullan
Bölüm başlığı “Kütüphaneyle kullan”MuJoCo’da tek bir komut listesinin birçok başlangıç state’inden open-loop replay’i tek bir mujoco.rollout çağrısıdır; dokümantasyon onu “open-loop trajectories from initial states” yürütmek diye tanımlıyor:
from mujoco import rolloutspec = mujoco.mjtState.mjSTATE_FULLPHYSICSx0 = np.zeros((len(shifts), mujoco.mj_stateSize(m, spec)))for i, s in enumerate(shifts): # one start state per cube position mujoco.mj_resetData(m, d) d.qpos[arm], d.qpos[jaw], d.qpos[cube:cube + 2] = HOME_Q, G_OPEN, CUBE_HOME + s mujoco.mj_forward(m, d) mujoco.mj_getState(m, d, x0[i], spec)states, _ = rollout.rollout(m, mujoco.MjData(m), x0, ctrl[None]) # ctrl: (steps, nu), the same for allClosed loop için birinci dereceden retarget yerine IK’yı gözlenen pozdan yeniden çöz (ders 16’nın mj_jacSite üzerine kurulu ik’sı). Gerçek kolda LeRobot’un lerobot-replay --dataset.episode=0’ı kaydedilmiş bir episode’un action’larını geri oynatır (il_robots); Adım 3 gibi open loop.
Tuzaklar:
- Hangi observation hangi action’la. Bizim . frame’imiz başındaki state’i sonundaki komutla eşliyor. Komutu sonraki state’le eşlersen policy bir sonraki hedefi tahmin etmek yerine şimdiyi kopyalamayı öğrenir.
- Öyle eğitmediysen interpolate etme, tut. Kayıt “40 ms boyunca bu hedef” demek; frame’ler arasında interpolasyon jaw rampası gibi hızlı kısımların zamanlamasını değiştirir.
- Replay evaluation değildir. Kaydedilen noktada başarılı bir replay (Adım 2) kaymış bir küp hakkında hiçbir şey söylemez (Adım 3).
Yazdıktan sonra · 2 soru.
1. Sıfırdan yaz, Adım 5’te yeniden hedeflenen frame’ler küpü 24/24 alıyor, open-loop replay ise 10/24. Yeniden hedefleme neyi ekledi?
- Kayıttan daha yüksek bir frame hızı.
- Hareketten önce küpün tek bir gözlemi; her frame’i pinv(J_p) çarpı küp kayması kadar kaydırmak için kullanılıyor.
- 120 gösterim üzerinde eğitilmiş bir policy.
Neden: retarget her frame için ders 09’un Jacobian’ıyla q’ = q + pinv(J_p(q)) shift hesaplıyor; replay’in geri kalanı değişmiyor.
2. Yeniden hedeflemeden sonra alet noktası 1 cm kayma için 0,28 mm, 2 cm için 1,10 mm, 3 cm için 2,48 mm sapıyor. Neden böyle büyüyor?
- Jacobian büyük kaymalarda yanlış.
- Kaydedilmiş frame’lerdeki float32 yuvarlaması.
- Düzeltme birinci dereceden, yani kalan hata kaymanın karesiyle büyür.
Neden: Sıfırdan yaz, Adım 4; Deney’in yeniden planlaması bunun yerine IK’yı tam çözüyor (0,18 mm). Kaymayı 1’den 2 cm’ye çıkarmak hatayı yaklaşık dört katına çıkarıyor.
Tam script: experiments/26-teleop-replay-data/experiment.py, çıktı: output.txt. MuJoCo 3.17.0, NumPy 2.5.4, Apple Silicon Mac (Apple M5), deterministik. A kısmı önceki notebook’un (notebooks/26-teleop-replay-data.ipynb) port’udur; sayıları birebir tekrarlandı.
A. Replay ve yeniden planlama. SO-101, (22, 0) cm’deki 3 cm’lik, 30 g’lık bir küpü sabit 4,5 s’lik bir zaman çizelgesiyle alıyor (bekle, üstüne, in, kapat, kaldır, tut). Her 2 ms’lik adımın 6 komutu kaydediliyor: 2250 × 6. Sonra küp 8 yönde 0,5–5 cm kaydırılıyor (artı kayıt noktası: 81 deneme). Replay listeyi değiştirmeden gönderir; feedback zaman çizelgesini korur ama üç IK pozunu (üstüne, in, kaldır) küpün gerçek yerinden yeniden çözer. Başarı fiziksel: 4,5 s’de küpün altı ≥ 4 cm yukarıda ve iki çene de küpe değiyor.
rec_ctrl, _ = plan_a(m, d, I, CUBE_HOME) # record onceok_r, kind_r, _ = run_a(xy, rec_ctrl) # replay: same 2250 x 6 listctrl, _ = plan_a(m0, d0, ids(m0), xy) # feedback: re-plan from the cube poseok_f, kind_f, _ = run_a(xy, ctrl)Tahmin et: çeneler küpten daha geniş açılıyor, küçük kaymalar tolere edilmeli. Replay nerede çalışmayı bırakır?
| Küp kayması | Replay | Wilson %95 | Feedback | Replay başarısızlıkları |
|---|---|---|---|---|
| 0 cm | 1/1 | [0,21, 1,00] | 1/1 | – |
| 0,5 cm | 8/8 | [0,68, 1,00] | 8/8 | – |
| 1 cm | 7/8 | [0,53, 0,98] | 8/8 | itti 1 |
| 1,5 cm | 4/8 | [0,22, 0,78] | 8/8 | itti 4 |
| 2 cm | 3/8 | [0,14, 0,69] | 8/8 | itti 5 |
| 2,5 cm | 1/8 | [0,02, 0,47] | 8/8 | ıskaladı 2, itti 5 |
| 3 cm | 1/8 | [0,02, 0,47] | 8/8 | ıskaladı 2, itti 5 |
| 3,5 cm | 1/8 | [0,02, 0,47] | 8/8 | ıskaladı 6, itti 1 |
| 4 cm | 1/8 | [0,02, 0,47] | 8/8 | ıskaladı 6, itti 1 |
| 4,5 cm | 0/8 | [0,00, 0,32] | 8/8 | ıskaladı 6, itti 2 |
| 5 cm | 0/8 | [0,00, 0,32] | 8/8 | ıskaladı 7, itti 1 |
| toplam | 27/81 | 81/81 |
“İtti” = çeneler küpe değdi ama küp zeminde kaldı; “ıskaladı” = çeneler küpe hiç değmedi. Aralıklar ders 25’in Wilson formülüyle; satır başına 8 denemeyle geniş oldukları için tek tek satırları değil eğilimi okuyun.
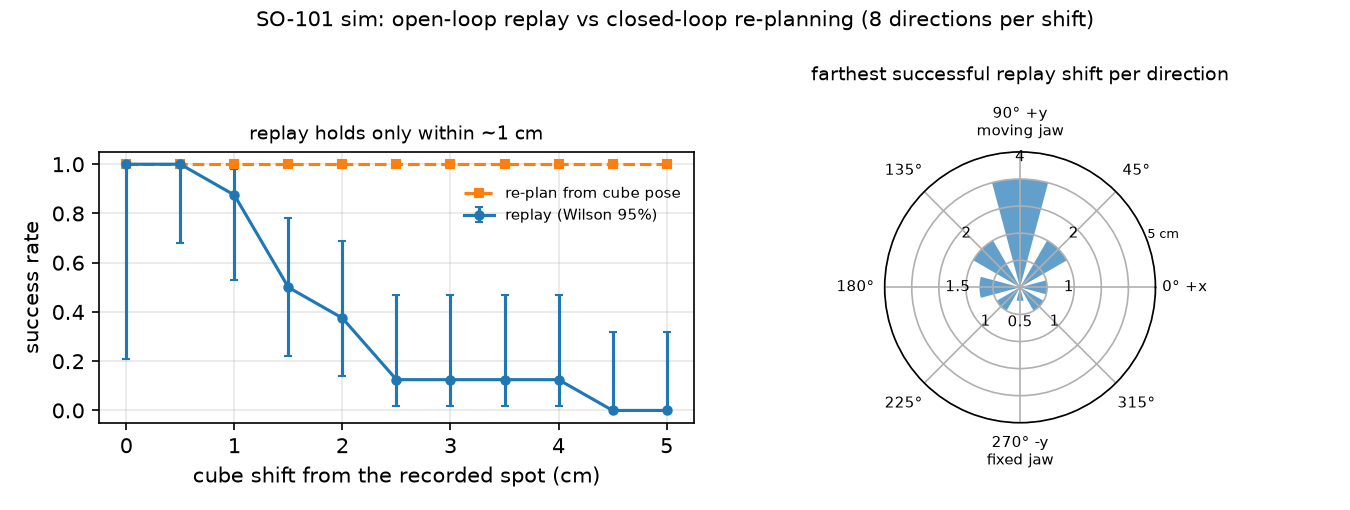
B. 27–29. dersler için demonstration’lar. Ders 16’nın scripted_pick’i, x ∈ [16, 28] cm, y ∈ [−8, 8] cm içinde düzgün dağılımla çekilen 120 küp konumunda (seed 26), 25 Hz’de kaydediliyor:
r = pick16.scripted_pick(scene.m, scene.d, cube_pos, record=True) # 2 ms stepsobs.append(scene.obs_from_qpos(tr[k * K - 1][2])) # o_k: 5 arm joints, jaw, cube xyzact.append(tr[k * K + K - 1][3]) # a_k: 6 joint targets [rad]| Büyüklük | Değer |
|---|---|
| episode (fiziksel başarı) | 120/120 |
| episode başına frame | 114 (4,56 s) |
| toplam frame | 13680 |
| observation | 9: 5 kol joint’i, çene, küp x/y/z |
| action | 6 joint pozisyon hedefi |
| dosya | demos.npz, 0,47 MB |
Dosya ayrıca episode_index, frame_index, timestamp, frame başına expert’in fazını, episode başına küp konumunu ve başarı bayrağını, ve görev metnini saklıyor.
C. Veri kendi içinde tutarlı mı? İlk 20 episode’un kaydedilmiş 25 Hz action’larını replay etmek (zero-order hold, aynı küp konumu) 20/20 başarılı (Wilson %95 [0,84, 1,00]). 500 Hz komutları 25 Hz’e seyreltmek pick’i bozmadı: dataset, en azından kendi state’lerinde, expert’i tarif ediyor.
Bozan parametre küp kayması ve başarısızlık yöne bağlı:
| Yön | 0° (+x, ileri) | 45° | 90° (+y) | 135° | 180° | 225° | 270° (−y) | 315° |
|---|---|---|---|---|---|---|---|---|
| en uzak replay başarısı | 1 cm | 2 cm | 4 cm | 2 cm | 1,5 cm | 1 cm | 0,5 cm | 1 cm |
+y yönünde replay 4 cm’de hâlâ tutuyor; −y yönünde 1 cm’de zaten başarısız; ileri ve geri tolerans 1–1,5 cm. Mekanizma (bizim yorumumuz; contact’lar ölçülmedi): SO-101’de bir sabit çene ve kapanırken ona doğru süpüren bir hareketli çene var. Hareketli çeneye doğru kaymış bir küp sabit çeneye süpürülür; sabit çeneye doğru kaymış olana sabit çene inerken çarpar ve onu iter. Yaklaşık 2 cm’ye kadar başarısızlıkların çoğu “itti”, 3,5 cm’den itibaren çoğu “ıskaladı”. Open-loop tolerans kaydın değil gripper geometrisinin bir özelliği.
Gerçek robotta
Bölüm başlığı “Gerçek robotta”- LeRobot ile teleoperation ve kayıt (prosedür; kendi kolumuzda henüz ölçülmedi). Follower ve leader’ı kalibre et (
lerobot-calibrate), çiftilerobot-teleoperate --robot.type=so101_follower --teleop.type=so101_leader ...ile kontrol et, sonralerobot-record ... --dataset.num_episodes=... --dataset.single_task="..."ile kaydet. Teleoperation, kayıt ve evaluation için aynı--robot.id’yi kullan, çünkü id kalibrasyon dosyasını seçer (il_robots). - Dokümantasyonun hız ve sayılar hakkında dediği. Örnekler kameraları ve kontrol döngüsünü 30 fps’te çalıştırıyor. Varsayılanlar: episode başına 60 s, 60 s reset, 50 episode. Önerileri “en az 50 episode, konum başına 10 episode” kaydetmek, kameraları sabit ve grasp’i tutarlı tutmak, çeşitliliği yavaş yavaş eklemek (il_robots). Kayıt sırasında → episode’u erken bitirir, ← yeniden kaydeder, Esc durdurur.
- Leader kol follower değildir. Follower 1/345 dişlili 6 STS3215 servo kullanıyor; leader, kolay hareket etsin diye 1/191, 1/345 ve 1/147 dişlileri karıştırıyor (SO-101 dokümantasyonu). Kalibrasyon ikisini aynı joint değerlerine eşler; kalibrasyon hatası dataset’te action hatası olur.
- Donanımda replay testi (prosedür, ölçülmedi): bir pick kaydet, küp kayıt noktasındayken, sonra 8 yönde 0,5–3 cm kaydırılmışken
lerobot-replay --dataset.episode=0çalıştır, her biri 1 deneme; mesafe başına k/n’yi Wilson aralıklarıyla raporla. Farklı bir tolerans bekle: gerçek sürtünme, çene pad’leri ve servo takibi modelden farklı.
Kendini dene
Bölüm başlığı “Kendini dene”Hızlı kontrol · 2 soru. Bir cevaba tıkla.
1. Replay küpe hiç bakmıyor. Küçük kaymalardan sonra küpü yine de neden alıyor?
- Replay her segmentin başında küp konumunu yeniden okuyor.
- Kaydedilen çene açıklığı küpten geniş; küçük bir kayma küpü yine çenelerin arasında bırakır. Tolerans gripper geometrisinden gelir.
- Pozisyon servoları kaydedilmiş joint hedeflerini küpün yeni konumuna uyarlıyor.
Neden: Matematik ayrıntısı, “Replay neden biraz da olsa tolere eder”; A kısmı: replay 0,5 cm’de 8/8, 1,5 cm’de 4/8, 4,5 cm’den itibaren 0/8; yeniden planlama ise 81/81.
2. Replay +y yönünde 4 cm’de hâlâ başarılı, −y yönünde ise yalnızca 0,5 cm’de. Dersin yorumu ne?
- Hareketli çene, kendisine doğru kaymış bir küpü sabit çeneye süpürür; sabit çeneye doğru kaymış bir küpe ise sabit çene inerken çarpar ve onu iter.
- Inverse kinematics kolun −y tarafında daha az doğru.
- Kayıt sırasında küp biraz +y’ye kaymıştı.
Neden: Boz tablosu: en uzak replay başarısı 90°‘de (+y) 4 cm, 270°‘de (−y) 0,5 cm. Ders mekanizmayı kendi yorumu olarak işaretliyor; contact’lar ölçülmedi.
- Kolay. 1,5 cm’de replay 4/8 yaptı. Tabloya göre o kaymada gerçek oran 0,75 olabilir mi?
- Orta. A kısmındaki feedback controller 81/81 yaptı. Simülasyonda bedavaya aldığı ve gerçek bir algı hattının ona vermeyeceği iki şeyi say.
- Zor. B kısmında
FPS’i 5 yap (her 100 ms’de bir frame) ve C kısmını yeniden çalıştır. Önce tahmin et: seyreltilmiş action’ları replay etmek küpü yine 20/20 alır mı?
Cevaplar
Bölüm başlığı “Cevaplar”- Evet. 4/8 için Wilson %95 aralığı [0,22, 0,78] ve 0,75’i içeriyor.
- Küpün tam konumu (kamera yok, gürültü yok, kalibrasyon hatası yok) ve bu konum hareketten önce bir kez, gecikmesiz okunuyor. Ayrıca kol modelinin servoları planı modellendiği gibi takip ediyor.
- Burada hesaplanmadı; çalıştır. 100 ms’lik bir hold’un 0,3 s süren çene rampasına ne yaptığına bak.
Akılda kalanlar ve kaynaklar
Bölüm başlığı “Akılda kalanlar ve kaynaklar”- Replay open loop’tur: tüm kaymalarda 27/81 başarı (küp gerçekten kaydırıldığında 26/80), ölçülen küp pozundan yeniden planlamada 81/81, simülasyonda.
- Open-loop toleransı gripper geometrisi belirler ve yöne bağlıdır: hareketli çeneye doğru 4 cm, sabit çeneye doğru 1 cm’nin altı.
- Bir demonstration dataset’i frame başına (observation, action) çiftleridir ve episode’lara gruplanır; 120 scripted demo’muz (25 Hz’de 13680 frame, 0,47 MB) kendi başlangıç state’lerinden 20/20 replay ediliyor.
Sonraki: ders 27 · Robot dataset’leri.
Kaynaklar:
- LeRobot, Imitation learning on real-world robots (teleoperate, record, replay, kayıt parametreleri, veri önerileri; okundu 2026-10-27).
- LeRobot, SO-101 (motorlar, leader dişlileri, kalibrasyon; okundu 2026-10-27).
- Lynch & Park, Modern Robotics, bölüm 11.
- MuJoCo Menagerie
robotstudio_so101(Apache-2.0). - Ölçülen tüm sayılar:
experiments/26-teleop-replay-data/output.txt.