33 · Continuous control için PPO
| Bölüm | 8 · Robotlar için reinforcement learning |
| Çalışma türü | CPU · Mac ya da Colab CPU |
| Önkoşul | 32 |
| Önce öğren | Policy Gradient — REINFORCE from Scratch · Actor-Critic — A2C and A3C · Proximal Policy Optimization (PPO) |
| Süre | ~75 dk |
| Kod | experiments/33-ppo/experiment.py |
| Durum | ✅ tam |
Bu derste yap
Her adımı yapınca işaretle. Yalnız bu tarayıcıda saklanır.
PPO’nun kendisi birkaç satır matematik. Robotta asıl iş, etrafındaki zaman ölçeklerini seçmek.
Problem
Bölüm başlığı “Problem”Ders 32’de rastgele bir policy hedefe 200 episode’un 1’inde ulaştı, Jacobian’ı modelden okuyan scripted IK controller ise 200’ünde de. Bir policy aynı uzanmayı yalnızca reward’dan, CPU’da, run başına yaklaşık bir dakikada öğrenebilir mi? Tek bir training run’ı sonuç değildir; bu yüzden başarıyı sabit evaluation episode’ları üzerinden, Wilson %95 aralığıyla (ders 25) ve üç seed için veriyoruz.
Okumadan önce · 2 soru. Önce tahmin et; nedenini ders anlatıyor.
1. 50 Hz’de 1,6 s’lik uzanmada neden ‘ten çok daha kötü sonuç verdi?
- 50 Hz’de 0,99, birkaç yüz milisaniyelik bir uzanmadan çok daha uzun, 2,0 s’lik bir ufuktur; 300k adımlık bütçede %99,3’e karşı %53,0’a ulaştı.
- ile clip artık güncellemeyi sınırlamaz.
- , policy’nin bir adımdan sonraki her reward’u yok saymasına yol açar.
Neden: s. γ sweep tablosu, 298/300’e karşı 159/300; ders mekanizmayı ayrıştırmadı ve sonuç bütçeyle sınırlı.
2. Bir deneme grubundan sonra PPO her action’ın sonucunu critic’in o state’ten beklediğiyle karşılaştırıyor. Hangi action’lar daha olası hâle gelir?
- Pozitif ödül alan her action.
- Beklenenden iyi çıkan action’lar (pozitif advantage), ve güncelleme başına olasılıklarında yalnızca %20’lik bir değişim içinde.
- Critic’in gruptan önce en yüksek puanladığı action’lar.
Neden: Burada her ödül , yani “pozitif ödül” hiç olmuyor; advantage olağandan iyi mi kötü mü olduğunu ölçer, ‘deki clip de değişimi sınırlar (Sıfırdan yaz, Adım 4).
Ana fikir
Bölüm başlığı “Ana fikir”Sade anlatımla
Bölüm başlığı “Sade anlatımla”PPO (Proximal Policy Optimization) kendi denemelerinden öğrenir, ama bir seferde fazla değişmeyi reddeder. Policy görevi action’larına biraz gürültü ekleyerek defalarca dener ve her deneme grubundan sonra her action için sorar: “bu, buradan genelde aldığım sonuçtan daha mı iyi gitti, daha mı kötü?” Bu farka advantage denir; “genelde ne alırım” bilgisi ikinci bir ağdan, critic’ten gelir. Advantage’ı pozitif olan action’lar biraz daha olası, diğerleri biraz daha az olası hâle gelir.
“Bir seferde fazla değil” kısmı onu kararlı yapar. Batch eski policy ile toplandı, dolayısıyla yalnızca ona yakın policy’ler hakkında güvenilir bir şey söyler; tıpkı geçen haftanın build’inin benchmark’ının baştan yazılmış bir sürüm hakkında pek bir şey söylememesi gibi. PPO, bir action’ı öncekinden %20’den fazla daha olası (ya da daha az olası) yapmaktan gelen kazancı yok sayar: clip.
Robotta bir ayarın daha fiziksel bir anlamı vardır: discount , yani bir adım sonraki reward’un ne kadar sayıldığı. Bir adım gerçek zamanda 20 ms’dir; dolayısıyla , policy’nin kaç saniye ilerisini önemsediğini sessizce belirler.
Bir PPO iterasyonu
Bölüm başlığı “Bir PPO iterasyonu”flowchart TD
A["policy (actor)<br/>ortalama action + gürültü"] --> B["rollout topla<br/>16 env × 64 adım"]
B --> C["critic her durumun<br/>value'sunu tahmin eder"]
C --> D["advantage (GAE):<br/>beklenenden iyi mi kötü mü?"]
D --> E["10 epoch güncelleme,<br/>olasılık oranı 1 ± 0,2'ye clip"]
E --> A
PPO, kod olarak
Bölüm başlığı “PPO, kod olarak”# One iteration, simplified (the full version is experiments/33-ppo/ppo.py)batch = collect(policy, envs, steps=64) # obs, actions, rewards, log-probs under the OLD policyvalues = critic(batch.obs) # expected future reward from each stateadv = gae(batch.rewards, values, gamma=0.95, lam=0.95) # better (+) or worse (-) than expectedfor epoch in range(10): ratio = policy.prob(batch.actions) / batch.old_prob # how much more likely each action is now clipped = ratio.clip(1 - 0.2, 1 + 0.2) # changes beyond 20% earn nothing loss = -mean(min(ratio * adv, clipped * adv)) # raise good actions, lower bad ones optimize(loss + 0.5 * critic_loss)
horizon_s = dt / (1 - gamma) # 0.02 / (1 - 0.95) = 0.4 s of look-ahead| Parça | Formül |
|---|---|
| Gaussian policy | |
| TD hatası, GAE | |
| clipped surrogate | |
| ufuk |
actor’ün observation’ı için ortalama action’ı, öğrenilen gürültüsüdür; episode’un bittiği adımda 1’dir; advantage ‘de bias ile variance’ı dengeler; olasılık oranı, clip’tir; critic’in hedefi, ve value loss’un ve entropy bonusu ‘nin ağırlıklarıdır; policy periyodudur.
Matematik ayrıntısı: continuous control'ün dört parçası
Policy gradient, actor-critic ve PPO türetmeleri AIEFS’te var; burada yalnızca continuous control için önemli olan kısımlar var.
Gaussian policy. Actor diagonal bir Gaussian’ın ortalamasını verir; observation’dan bağımsız, öğrenilen bir vektördür. Environment ‘yı ‘e clip eder, ama log-probability clip edilmemiş örnek için hesaplanır; böylece tutarlı kalır.
GAE (Schulman vd., arXiv 1506.02438). yalnızca ‘yi kullanır (düşük variance, critic yüzünden bias’lı); tüm gerçek reward’ları toplar (bias’sız, gürültülü). Makale ‘yı da aynı şekilde, bir variance azaltma parametresi olarak ele alır.
Clipped surrogate (Schulman vd., arXiv 1707.06347). , yeni policy’nin iyileşmesini eski policy’nin örneklerinden tahmin eder (importance sampling) ve yalnızca civarında güvenilirdir; clip’li terimle minimum almak dışına çıkma teşvikini ortadan kaldırır (Sıfırdan yaz, Adım 4).
Truncation, termination değildir. 1,6 s’lik sınırda son reward’a bootstrap eklenir, , sonra episode kesilir (); gerçek bir terminal durum (ders 35) bootstrap almaz.
Neden . ağırlıklarının toplamı adımdır; adım süresiyle çarpınca bir zaman olur. 50 Hz’de 2 s, 0,4 s demektir. Kontrol hızını değiştirirseniz görevin ufkunu sessizce değiştirmiş olursunuz.
Daha derine: Policy Gradient — REINFORCE from Scratch, Actor-Critic — A2C and A3C, Proximal Policy Optimization (PPO); yukarıdaki PPO ve GAE makaleleri.
Ayarlarımız ve gerçek bir robot config’i
Bölüm başlığı “Ayarlarımız ve gerçek bir robot config’i”| Bu ders | Go2 training config’i (unitree_rl_gym) | |
|---|---|---|
| paralel env × iterasyon başına adım | 16 × 64 | 4096 × 24 |
| iterasyon başına epoch / minibatch | 10 / 4 | 5 / 4 |
| clip , , | 0,2, 0,95, 0,95 | 0,2, 0,99, 0,95 |
| learning rate | 1e-3, sabit | 1e-3, schedule = 'adaptive', desired_kl = 0.01 |
| entropy katsayısı | 0 | 0,01 |
| policy ağı | 64-64 tanh | 512-256-128 elu |
Sağ sütun legged_robot_config.py (LeggedRobotCfgPPO) ve go2_config.py dosyalarından okundu.
Sıfırdan yaz
Bölüm başlığı “Sıfırdan yaz”Şimdi PPO’nun parçalarını kendin yazacaksın, her birini elle hesaplanan değerlere, SciPy’ye ya da autograd’a karşı kontrol edeceksin ve reach görevinde dersin ppo.py’siyle birebir aynı çıkması gereken tek bir PPO iterasyonu kuracaksın. Adım 5 seed başına tek bir iterasyon (1024 örnek) koşturur, Deney’in 300.000 adımlık training’lerini değil; script yaklaşık 6 s sürer.
Fonksiyonlar physai/rl.py içinde; uv run python experiments/33-ppo/build.py altı adımın hepsini koşturur (çıktı build_output.txt dosyasında).
Adım 1 · GAE
Bölüm başlığı “Adım 1 · GAE”Generalized advantage estimation rollout’ta geriye doğru ilerler, adım başına bir TD hatasıyla:
def gae(rewards, values, last_value, dones, gamma, lam):    """Generalized advantage estimation over a (T, N) rollout, backwards in time; returns (advantages, returns).
    dones[t] = 1 where an episode ended after step t (terminated or truncated); a truncated step's reward    must already include gamma * V(s_final).    """    adv = np.zeros_like(rewards)    run = np.zeros_like(last_value)    for t in reversed(range(len(rewards))):        next_v = last_value if t == len(rewards) - 1 else values[t + 1]        nonterminal = 1.0 - dones[t]        delta = rewards[t] + gamma * next_v * nonterminal - values[t]   # TD error        run = delta + gamma * lam * nonterminal * run        adv[t] = run    return adv, adv + values
Elle üç adım, ile: , , ; ile ve .
== Step 1. GAE on three steps: r = (1, 0, 2), V = (0.5, 0.4, 0.3), V(s_3) = 0.2, gamma 0.9 ==lambda 0.8: A = [1.740992 1.2236 1.88 ], returns = [2.240992 1.6236 2.18 ]lambda 0.0: A = [ 0.86 -0.13 1.88], returns = [1.36 0.27 2.18]lambda 1.0: A = [2.2658 1.562 1.88 ], returns = [2.7658 1.962 2.18 ]TD errors delta = [ 0.86 -0.13 1.88] (= lambda 0); discounted return - V = [2.2658 1.562 1.88 ] (= lambda 1)64 x 16 rollout, no episode ends: max |gae - direct double sum| = 5.3e-15TD hatalarını, discount’lu return eksi value’yu geri veriyor: Matematik ayrıntısındaki ayarın iki ucu. 64 × 16’lık bir rollout’ta döngü doğrudan çift toplamla 5,3e-15’e kadar aynı.
Adım 2 · Rollout içinde biten episode’lar
Bölüm başlığı “Adım 2 · Rollout içinde biten episode’lar”64 adımlık bir rollout episode sınırlarını aşar; dones[t] = 1 bootstrap’i ve birikmiş toplamı keser, böylece hiçbir advantage bir sonraki episode’a sızmaz:
== Step 2. Episode ends inside the rollout ==49 episode ends: max |gae - per-episode sums| = 3.1e-15truncated step: r + gamma * V(s_final) is stored and done = 1, so the future is not lost: -0.200 for r = -0.01, V(s_final) = -0.200Truncated bir adımın reward’u zaten ‘ı içeriyor (Matematik ayrıntısı); dolayısıyla toplamı kesmek hiçbir şey kaybettirmiyor.
Adım 3 · Gaussian policy’nin log-probability’si
Bölüm başlığı “Adım 3 · Gaussian policy’nin log-probability’si”def gaussian_log_prob(a, mu, log_std): """Log-density of a diagonal Gaussian policy, summed over the action dimensions.""" z = (a - mu) / np.exp(log_std) return (-0.5 * z ** 2 - log_std - 0.5 * np.log(2 * np.pi)).sum(-1)== Step 3. Gaussian log-probability, 1000 actions in 4-D ==max |ours - scipy| = 1.8e-15, max |ours - torch| = 2.7e-15at the mean: 0.3242 = 4 * (1 - 0.5 ln 2 pi) = 0.3242Ortalamada, ile, her boyut katkı veriyor, dört boyut için 0,3242: dar bir Gaussian’ın log-density’si 0’ın üstündedir.
Adım 4 · Clipped surrogate
Bölüm başlığı “Adım 4 · Clipped surrogate”Loss’un türevi alınmalı, bu yüzden tensor’lar üzerinde çalışır; .clamp ve .minimum tensor metodlarıdır ve physai’nin PyTorch’u import etmesi gerekmez:
def clipped_surrogate(ratio, adv, clip=0.2): """PPO's policy loss on PyTorch tensors: -mean(min(ratio * A, clip(ratio, 1 - eps, 1 + eps) * A)).""" unclipped = ratio * adv clipped = ratio.clamp(1 - clip, 1 + clip) * adv return -unclipped.minimum(clipped).mean()== Step 4. The clipped surrogate, eps = 0.2 == ratio A objective min(rA, clip(r)A) d objective / d ratio 0.7 +1 0.70 1.0 0.9 +1 0.90 1.0 1.1 +1 1.10 1.0 1.3 +1 1.20 0.0 0.7 -1 -0.80 0.0 0.9 -1 -0.90 -1.0 1.1 -1 -1.10 -1.0 1.3 -1 -1.30 -1.0Gradient sütununu oku. Pozitif advantage’da oranı artırmak ‘ye kadar kazandırır, sonra gradient 0,0 olur; negatif advantage’da aynısı 0,8’in altında olur. Öbür yönde gradient kalır: amacı kötüleştiren bir hareket asla clip’lenip yok edilmez.
Adım 5 · Tek iterasyon, ppo.py’ye karşı
Bölüm başlığı “Adım 5 · Tek iterasyon, ppo.py’ye karşı”def approx_kl(logp_old, logp_new): """The cheap KL estimate PPO logs per update: mean of log pi_old - log pi_new over the batch's actions.""" return (logp_old - logp_new).mean()İterasyon ppo.py’nin ağını ve dersin environment’ını, güncelleme için ise senin fonksiyonlarını kullanır. Minibatch adımının özü:
A = (A - A.mean()) / (A.std() + 1e-8)pg = clipped_surrogate((lp - b_lp[mb]).exp(), A, cfg.clip)vl = ((pi.v(b_o[mb]).squeeze(-1) - b_ret[mb]) ** 2).mean()loss = pg + cfg.vf_coef * vl - cfg.ent_coef * d.entropy().sum(-1).mean()== Step 5. One PPO iteration (16 envs x 64 steps, 10 epochs x 4 minibatches) ==seed 0: approx KL ours 0.011696, ppo.py 0.011696; max |weights ours - ppo.py| = 0.0e+00reference (eps 0.2, 10 epochs): ppo.py iteration-1 KL, seeds 0/1/2 = 0.0117 / 0.006815 / 0.004259, mean 0.00759Break it (eps 100, 30 epochs): ppo.py iteration-1 KL, seeds 0/1/2 = 1.493 / 1.583 / 1.939, mean 1.67Senin iterasyonun ppo.py’nin ilk iterasyonuyla aynı ağırlıkları veriyor (fark 0,0e+00): Deney’in güncellemesi senin yazdığın güncelleme. Üç seed’in ilk iterasyon KL’sinin ortalaması 0,00759, yani Boz’un altındaki referans satırı; clip olmadan ve 30 epoch ile 1,493 / 1,583 / 1,939, yani Boz tablosunun ilk sütunu. Trust region daha ilk güncellemede kayboluyor.
Adım 6 · Ufuk olarak discount
Bölüm başlığı “Adım 6 · Ufuk olarak discount”def horizon_seconds(dt, gamma): """How far ahead a discount looks, in seconds: the weights gamma^l sum to 1 / (1 - gamma) steps.""" return dt / (1.0 - gamma)== Step 6. The discount as a time horizon, policy period 20 ms == gamma horizon 0.900 0.20 s 0.950 0.40 s 0.990 2.00 s 0.995 4.00 ssweep’inin ufuk sütunu: en iyi ayar için 0,4 s, varsayılan 0,99 için 2 s.
Elinde kalan
Bölüm başlığı “Elinde kalan”physai.rl artık gae, gaussian_log_prob, clipped_surrogate, approx_kl ve horizon_seconds fonksiyonlarını da içeriyor. Ders 34, kontrol hızı başına seçmek için horizon_seconds’ı tersinden kullanıyor. tests/test_33_ppo.py GAE’yi doğrudan toplama ve özel durumlarına karşı, episode kesmesini, log-probability’yi SciPy’ye karşı ve clip’in değerleriyle gradient’lerini kontrol ediyor; uv run pytest tests/test_33_ppo.py çalıştır.
Kütüphaneyle kullan
Bölüm başlığı “Kütüphaneyle kullan”Tek makinede hazır bir PPO için Stable-Baselines3 herhangi bir gymnasium.Env’i kabul eder, örneğin ders 32’nin GymReach’ini (burada çalıştırılmadı: SB3 bu reponun bir bağımlılığı değil):
from stable_baselines3 import PPOmodel = PPO("MlpPolicy", env, n_steps=64, batch_size=256, n_epochs=10, gamma=0.95, gae_lambda=0.95, learning_rate=1e-3, clip_range=0.2) # this lesson's settings, with one envmodel.learn(total_timesteps=300_000)Varsayılanları bu dersinkilerden farklı (PPO dokümantasyonu):
| Ayar | Bu ders (ppo.py) | Stable-Baselines3 PPO varsayılanı |
|---|---|---|
| env başına rollout uzunluğu | 64 (× 16 env) | n_steps = 2048 |
| minibatch boyutu | 256 | batch_size = 64 |
| epoch | 10 | n_epochs = 10 |
| discount, GAE | 0,95, 0,95 | gamma = 0.99, gae_lambda = 0.95 |
| learning rate | 1e-3 | 3e-4 |
| clip, value ve entropy ağırlıkları | 0,2, 0,5, 0 | clip_range = 0.2, vf_coef = 0.5, ent_coef = 0.0 |
| gradient norm clip’i | 0,5 | max_grad_norm = 0.5 |
| advantage normalization | minibatch başına | normalize_advantage = True |
Üç tuzak:
- bir varsayılandır, yasa değil. 50 Hz’de 2 s’lik bir ufuktur ve Deney’de başarıyı 0,95’e göre yarıya indirdi (159/300’e karşı 298/300). Onu Adım 6 ile görevin zaman ölçeğinden belirle.
- SB3’te
batch_sizeminibatch’tir; rolloutn_steps × n_envs’tir. - Truncation öğrenene yalnızca
infoüzerinden ulaşır. SB3, info dict’iTimeLimit.truncated’ı ve son observation’ı taşıdığında zaman sınırı adımını bootstrap eder (ders 32, Kütüphaneyle kullan); kendi döngünde ‘ı,ppo.py’nin yaptığı gibi, kendin ekle.
Yazdıktan sonra · 2 soru.
1. Sıfırdan yaz, Adım 4’te ratio 1,3 ve advantage +1. Clipped surrogate ratio’ya hangi gradient’i geçirir, neden?
- 0,0; ‘nin üstünde bu action’ı daha da olası yapmaktan kazanılacak bir şey kalmaz.
- 1,0; clip aralığının içindekiyle aynı.
- −1,0; ratio’yu 1’e geri iter.
Neden: Amaç orada = 1,20. ile gradient bunun yerine 0,8’in altında kaybolur (ratio 0,7’de 0,0); amacı kötüleştiren hareketler gradient’ini korur.
2. Stable-Baselines3’e geçiyorsun ve bu dersin iterasyon başına 1024 örneğini beklerken batch_size=1024 veriyorsun. Neyi ayarlamış oldun?
- Rollout uzunluğunu; SB3 iterasyon başına 1024 örnek toplar.
- Epoch sayısını.
- Minibatch boyutunu; rollout
n_steps × n_envs’tir (varsayılann_steps = 2048), bu dersin minibatch’i ise 256.
Neden: Kütüphaneyle kullan, tablo ve tuzaklar. Dersin 1024 örneği 16 ortam × 64 adımdır, 10 epoch’un her birinde 256’lık 4 minibatch’e bölünür.
ppo.py algoritmanın tamamı (yaklaşık 200 satır, RL kütüphanesi yok); experiment.py onu çalıştırır. Environment, ders 32’deki reach görevinin aynısı: mutlak joint hedefleri, 50 Hz, reward , run başına 300.000 policy adımı. Güncellemesi Sıfırdan yaz’da senin yazdığın güncelleme (Adım 5 onu ağırlık ağırlık tuttu).
Çalıştırmadan önce tahmin edin: 0,9’dan 0,995’e giderken 1,6 s’lik bir uzanma için hangi ufuk en iyi çalışır?
MuJoCo 3.17.0, NumPy 2.5.4, PyTorch 2.14.1 (CPU, run başına bir thread), Apple Silicon Mac (Apple M5). Her run kendi seed’i için deterministik: tam bir tekrar çalıştırma, output.txt içindeki süreler dışında her sayıyı aynen üretti. Evaluation, seed’i 10000–10099 olan episode’larda ortalama action’la (gürültüsüz) yapılır.
Referans config, üç seed:
| seed | başarı | Wilson %95 | medyan son mesafe | training süresi |
|---|---|---|---|---|
| 0 | 100/100 | %96,3–100,0 | 6,6 mm | 61 s |
| 1 | 98/100 | %93,0–99,4 | 7,9 mm | 61 s |
| 2 | 100/100 | %96,3–100,0 | 8,0 mm | 60 s |
| toplam | 298/300 (%99,3) | %97,6–99,8 |
Training süreleri yaklaşık duvar saati süreleridir (paylaşılan bir Mac’te altı run paralel); script’in tamamı 222 s sürdü. python experiment.py --quick yalnızca seed 0’ı eğitir (5 run) ve her tablonun seed 0 girdilerini yeniden üretir, toplam sayıları değil.
Ortam adımına göre training başarısı (gürültülü policy, son 50 episode):
| seed | 50k | 100k | 150k | 200k | 250k | 299k |
|---|---|---|---|---|---|---|
| 0 | 0,20 | 0,14 | 0,18 | 0,68 | 0,96 | 1,00 |
| 1 | 0,16 | 0,22 | 0,28 | 0,40 | 0,92 | 0,96 |
| 2 | 0,16 | 0,20 | 0,28 | 0,88 | 0,94 | 0,98 |
150k adım boyunca training başarısı 0,14 ile 0,28 arasında kalıyor, sonra yaklaşık 100k adım içinde sıçrıyor; 150k’da durdurulan bir run başarısız görünürdü.
sweep’i (her biri 3 seed, toplam 300 evaluation episode’u):
| 50 Hz’de ufuk | seed başına başarı | toplam | Wilson %95 | |
|---|---|---|---|---|
| 0,9 | 0,2 s | 77 / 97 / 98 | 272/300 (%90,7) | %86,8–93,5 |
| 0,95 | 0,4 s | 100 / 98 / 100 | 298/300 (%99,3) | %97,6–99,8 |
| 0,99 | 2,0 s | 32 / 74 / 53 | 159/300 (%53,0) | %47,3–58,6 |
| 0,995 | 4,0 s | 25 / 31 / 79 | 135/300 (%45,0) | %39,5–50,7 |
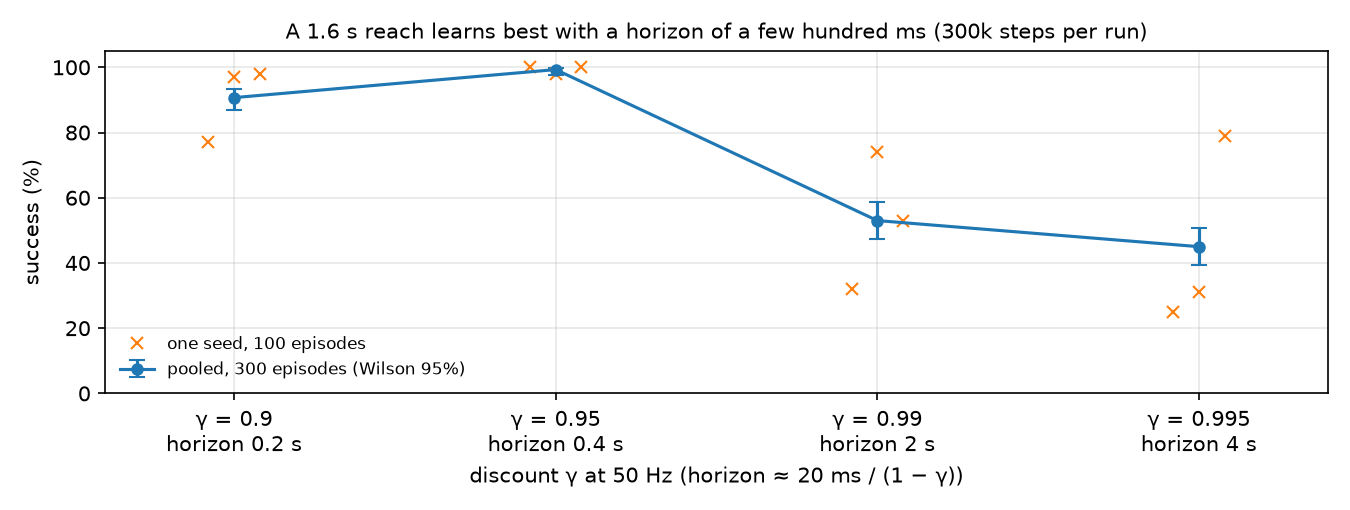
Yaygın varsayılan burada başarıyı yarıya indiriyor ve seed’ler arası fark büyüyor (0,995’te 100 üzerinden 25 ile 79): birkaç yüz milisaniyelik bir uzanmaya en iyi aynı mertebede bir ufuk hizmet etti. Mekanizmayı ayrıştırmadık. Adaylar: daha uzun ufuklar uzak reward’ların gürültüsünü her advantage’a ekler (GAE makalesinin bias-variance dengesi); ayrıca value hedefleri gibi büyür, ppo.py ise return’leri normalize etmez ve actor ile critic gradient’lerini ayrı clip’lemez, yani büyüyen value loss policy adımını da küçültür. Çekinceler: bütçe sabit (300k adım) ve Wilson aralıkları 300 episode’u sayar ama yalnızca üç eğitilmiş policy’ye dayanır. 0,95 ile 0,99 arasındaki fark her seed’de geçerli; 0,99 ile 0,995 arasındaki fark değil.
Aynı batch üzerinde on epoch’un policy’yi fazla uzağa yürütmesini engelleyen şey clip’tir. yapın (pratikte clip yok) ve her batch’i 30 epoch tekrar kullanın. Son sütun, batch’i toplayan policy ile güncellenen policy arasındaki yaklaşık KL divergence’tır: “iki action dağılımı ne kadar farklı” sorusunun sayısı; 0,01 civarı küçük ve sağlıklı bir adımdır.
| seed | başarı | Wilson %95 | medyan son mesafe | güncelleme başına yaklaşık KL, iter 1 / 10 / 50 / 100 / 292 |
|---|---|---|---|---|
| 0 | 0/100 | %0,0–3,7 | 196,5 mm | 1,49 / 3,1 / 8,2 / 435 / 3780 |
| 1 | 0/100 | %0,0–3,7 | 272,5 mm | 1,58 / 4,16 / 17,5 / 46,6 / 125 |
| 2 | 1/100 | %0,2–5,4 | 144,2 mm | 1,94 / 3,04 / 7,78 / 392 / 1070 |
| referans ( 0,2, 10 epoch) | 0,00759 / 0,0201 / 0,0211 / 0,0259 / 0,0657 (3 seed ortalaması) |
Mekanizma: yalnızca yakınında iyileşmenin geçerli bir tahminidir. Clip olmadan optimizer büyük advantage’lı örnekler için ‘yu itmeye devam eder, ortalama ve sıçrar ve yaklaşık KL 0,01 civarından yüzlere çıkar (ilk iterasyonda bile 1,49–1,94, Sıfırdan yaz, Adım 5). Sonraki batch critic’in fit edilmediği bir policy’den gelir; böylece advantage’lar da yanlış olur. Son mesafeler (144,2–272,5 mm), ders 32’deki rastgele policy ile aynı mertebededir (medyan 185,7 mm). Güncelleme başına yaklaşık KL’yi ve clip oranını izlemek en ucuz erken uyarıdır; Unitree’nin config’i bir adım ileri gidip learning rate’i bir KL hedefine göre ayarlar (desired_kl = 0.01).
Gerçek robotta
Bölüm başlığı “Gerçek robotta”- Eğitilmiş actor 15 → 64 → 64 → 4’lük bir MLP; deploy etmek ‘yu 50 Hz’de çalıştırıp dört çıktıyı servo hedefi olarak göndermek demektir. Critic geride kalır.
- Menagerie, STS3215 servolarını position actuator olarak modeller (
kp = 998.22,kv = 2.731,forcerange = ±2.94N·m,so101.xml); gerçek servonun döngüsü, gecikmesi ve boşluğu (backlash) farklıdır ve policy bunların hiçbiriyle eğitilmedi (Bölüm 9). - Gerçek kol için prosedür: 20+ ulaşılabilir hedeften oluşan sabit bir liste, deterministik policy’yi çalıştır, son gripper konumunu ders 20’deki kalibre kamerayla ölç, ‘yi Wilson aralığıyla raporla. Gerçek kolda henüz ölçülmedi.
Kendini dene
Bölüm başlığı “Kendini dene”Hızlı kontrol · 2 soru. Bir cevaba tıkla.
1. Training başarısı ilk 150k adım boyunca 0,14 ile 0,28 arasında kalıyor. Ne sonuç çıkarmalısınız?
- Run başarısız oldu; durdurup hyperparameter’ları değiştirin.
- Reward yanlış olmalı, çünkü çalışan bir PPO baştan itibaren düzenli olarak iyileşir.
- Henüz hiçbir şey; üç seed’in hepsinde başarı sonra yaklaşık 100k adım içinde sıçradı.
Neden: Öğrenme eğrisi tablosu: 150k’da 0,18 / 0,28 / 0,28, 250k’da 0,96 / 0,92 / 0,94. 150k’da durdurulan bir run başarısız görünürdü.
2. Boz bölümünde clip yapılıyor ve her batch 30 epoch tekrar kullanılıyor. Ne ters gider?
- Hiçbir şey; daha fazla epoch veriyi yalnızca daha iyi kullanır.
- Güncellenen policy batch’i toplayan policy’den çok uzaklaşır, surrogate artık geçerli değildir; yaklaşık KL yüzlere çıkar, başarı %0–1’e düşer.
- Action’lar aralığının dışına çıkar ve ortam çöker.
Neden: Boz tablosu, yaklaşık KL 100. iterasyonda 435 / 46,6 / 392, referansta ise 0,0259; son mesafeler 144,2–272,5 mm, rastgele bir policy mertebesinde.
- Kolay. Go2 config’inin ‘u, 50 Hz’lik policy hızında kaç saniyelik bir ufka karşılık gelir? 200 Hz’de aynı ufku hangi verir?
- Orta.
ppo.py’de truncation bootstrap’ini silin (zaman sınırını terminal durum gibi ele alın). Çalıştırmadan önce: hangi durumlar yanlış bir value alır, bu value fazla yüksek mi fazla düşük mü? Üç seed çalıştırıp referans tabloyla karşılaştırın. - Zor. Sabit learning rate’i KL’ye uyarlanan kuralla değiştirin (bir iterasyonun ortalama KL’si ‘i aşınca lr’yi yarıya indir, ‘nin altındaysa 1,5 kat büyüt). Boz ayarını kurtarıyor mu? Başarıyı üç seed için Wilson aralıklarıyla raporlayın.
Cevaplar
Bölüm başlığı “Cevaplar”- s. 200 Hz’de ( ms): .
- Zaman sınırına yakın durumlar. Buradaki her reward olduğundan geleceği kesmek bu durumların value hedeflerini bootstrap edilmiş hâllerinden fazla yüksek (sıfıra daha yakın) yapar; aynı kol durumu, observation’da olmayan saate göre farklı hedefler alır. Ölçün; bu varyantı biz çalıştırmadık.
- Açık; çalıştırmadık. İterasyon başına KL’yi başarıyla birlikte raporlayın, yoksa schedule’ı şanstan ayırt edemezsiniz.
Akılda kalanlar ve kaynaklar
Bölüm başlığı “Akılda kalanlar ve kaynaklar”- Kompakt bir PPO (Gaussian policy, GAE, clipped surrogate) SO-101 uzanmasını CPU’da öğreniyor: üç seed üzerinden 298/300 evaluation episode’u (Wilson %97,6–99,8), run başına yaklaşık bir dakika.
- saniye cinsinden bir ufuktur, ; 50 Hz’de aynı bütçeyle 0,95 (0,4 s) %99,3’e, varsayılan 0,99 (2 s) %53,0’a ulaştı.
- Clip olmadan ve verinin yoğun tekrar kullanımıyla KL patlıyor, başarı %0–1’e düşüyor; KL’yi ve clip oranını her güncellemede loglayın.
Sıradaki: ders 34, policy’nin ne gördüğü ve çıktılarının ne anlama geldiği.
Kaynaklar
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, O. Klimov, “Proximal Policy Optimization Algorithms”, 2017. arXiv 1707.06347
- J. Schulman, P. Moritz, S. Levine, M. Jordan, P. Abbeel, “High-Dimensional Continuous Control Using Generalized Advantage Estimation”, 2015. arXiv 1506.02438
- Gymnasium
EnvAPI (terminated ve truncated). unitree_rl_gym·legged_robot_config.py,go2_config.py(BSD-3-Clause).- MuJoCo Menagerie ·
robotstudio_so101(Apache-2.0). - Kod:
experiments/33-ppo/ppo.py,experiment.py,output.txt; şekilplot.pyile üretildi.