34 · Observation ve action tasarımı
| Bölüm | 8 · Robotlar için reinforcement learning |
| Çalışma türü | CPU · Mac ya da Colab CPU |
| Önkoşul | 33 |
| Önce öğren | Proximal Policy Optimization (PPO) |
| Süre | ~60 dk |
| Kod | experiments/34-observation-action-design/experiment.py |
| Durum | ✅ tam |
Bu derste yap
Her adımı yapınca işaretle. Yalnız bu tarayıcıda saklanır.
Robotu policy hareket ettirmez. Policy bir controller’la konuşur ve sayılarının ne anlama geldiği, ne öğrenebileceğinin çoğunu belirler.
Problem
Bölüm başlığı “Problem”Unitree’nin Go2 policy’si tork vermez. 12 çıktısı 0,25 ile ölçeklenir, varsayılan bir joint açısına eklenir ve policy adımı başına dört kez çalışan bir PD döngüsüyle takip edilir (go2_config.py, legged_robot.py · _compute_torques):
torques = self.p_gains*(actions_scaled + self.default_dof_pos - self.dof_pos) - self.d_gains*self.dof_velstiffness = 20, damping = 0.5, action_scale = 0.25, dt = 0.005’te decimation = 4 ile (50 Hz policy, 200 Hz PD). Neden tork değil de bu, ve neden bu sayılar? Ders 33’ün PPO’sunu sabit tutup SO-101 uzanmasında yalnızca arayüzü değiştiriyor; başarıyı, yumuşaklığı ve enerjiyi ölçüyoruz.
Okumadan önce · 2 soru. Önce tahmin et; nedenini ders anlatıyor.
1. Policy’ye hedef − gripper yerine mutlak hedef konumunu vermek başarıyı 298/300’den 101/300’e düşürdü. Neden?
- Hangi yöne gideceğini bilmek için policy artık forward kinematics’i kendisi öğrenmek zorunda.
- Mutlak konum daha uzun bir vektör, bu yüzden ağ fazla küçük kalıyor.
- Mutlak konum daha fazla gürültüyle ölçülür.
Neden: C bölümü, observation tablosu. Göreli hedef tek başına en önemli girdi; Go2 observation’ı da aynı şekilde, policy’nin hareket ettiği frame’de kurulur.
2. Bir policy bir servo için eklem hedefleri yerine 50 Hz’te doğrudan eklem torkları veriyor. Hangi ek işi üstlenir?
- Hiçbiri; tork ve hedef aynı komuttur.
- Yalnızca ters kinematik.
- Servonun hızlı döngüsünün yaptığı her şeyi, kolu yerçekimine karşı tutmayı ve hareketini sönümlemeyi, fizik hızında değil 50 Hz’te.
Neden: Basit anlatım ve Matematik ayrıntısı; hedeflerle PD döngüsü her 5 ms’lik fizik adımında çalışır. A kısmında torklar 272/300’e, mutlak hedefler 298/300’e ulaştı.
Ana fikir
Bölüm başlığı “Ana fikir”Sade anlatımla
Bölüm başlığı “Sade anlatımla”Policy, hızlı ve alt seviye bir servisi üç yoldan biriyle çağıran yavaş, üst seviye bir servistir. Tork: motor eforunu doğrudan yazar, donanım register’larını kurcalamak gibi; bu durumda kolu yerçekimine karşı tutmak ve hareketini sönümlemek policy’nin kendi işidir. Mutlak hedef: istediği eklem açısını gönderir; bir PD döngüsü (yay ve sönümleyiciden oluşan bir controller, ders 12) o açıyı saniyede yüzlerce kez kovalar. Delta hedef: önceki hedefi küçük bir adımla kaydırır.
Hedeflerle policy bir setpoint’i saniyede 50 kez kaydırır, gerisini alttaki sert döngü yapar. Bu çağrının etrafında üç seçim daha vardır: action ölçeği (bir birimlik çıktının ne kadar uzağa uzandığı ve keşif gürültüsünün radyan cinsinden ne kadar büyük olduğu), policy hızı ve observation (“hedef gripper’ımın biraz solunda” bilgisiyle hareket etmek, oda koordinatlarıyla hareket etmekten kolaydır).
Policy’den torka
Bölüm başlığı “Policy’den torka”flowchart TD
O["observation<br/>q, q̇, hedef − gripper, önceki action"] --> P["policy, 50 Hz<br/>a, [-1, 1] içinde"]
P --> S["ölçek ve ofset<br/>q* = q0 + s·a"]
S --> D["PD döngüsü, her fizik adımında<br/>τ = Kp (q* − q) − Kd q̇"]
D --> L["±τmax'a kes"]
L --> R["robot eklemleri"]
R --> O
P -. "tork modu:<br/>τ = τmax · a" .-> L
Üç arayüz, kod olarak
Bölüm başlığı “Üç arayüz, kod olarak”def torque(a, q, qd, q_star_prev, mode, s): # a: policy output in [-1, 1]^4, q / qd: joint angles / velocities, s: action scale if mode == "torque": return TAU_MAX * a # policy is the controller; held for k physics steps if mode == "absolute": q_star = Q0 + s * a # setpoint around the default pose q0 else: # "delta" q_star = q_star_prev + s * a # move the previous setpoint return clip(KP * (q_star - q) - KD * qd, -TAU_MAX, TAU_MAX) # PD, every physics step
gamma = 1 - policy_dt / 0.4 # keep a 0.4 s horizon when the rate changes| Ad | Policy çıktısının anlamı | Her fizik adımında tork |
|---|---|---|
| tork | adım boyunca tutulur | |
| mutlak hedef | , kesilmiş | |
| delta hedef | aynı PD |
policy çıktısı, ve eklem açıları ve hızları, joint hedefi, varsayılan poz, action ölçeği, ve PD gain’leri, tork sınırı ve policy adımı başına ms’lik fizik adımı sayısıdır.
Matematik ayrıntısı: servo, ölçek, hız ve observation ne yapar
SO-101 servosu zaten bir PD döngüsüdür. Her STS3215, kp = 998.22, kv = 2.731, forcerange = ±2.94 N·m’lik bir MuJoCo position actuator’üdür; MuJoCo onu her fizik adımının içinde hesaplar (XML referansı, actuator’ler). Tork modumuz bu döngüyü kaldırır ve actuator’leri motor olarak sürer ( N·m). Hedeflerle yerçekimi ve damping fizik hızında halledilir; torkla bunları policy 50 Hz’de, gürültüsü N·m cinsinden olarak halleder.
Action ölçeği. iki şeyi birden belirler: ulaşılabilir aralığı () ve fiziksel birimlerde keşif gürültüsünün büyüklüğünü (başlangıç policy std’si , rad olur). Go2 rad kullanır; bir gait varsayılan poz yakınında kalır, çalışma alanı boyunca uzanan bir kol kalmaz.
Policy hızı. . Daha hızlı bir policy daha erken tepki verir ama her kararın ağırlığı azalır ve saniye cinsinden aynı ufku korumak için discount’u değişmelidir (ders 33): alıyoruz.
Observation. Go2 policy’si 48 sayı görür (legged_robot.py · compute_observations): gövdenin doğrusal ve açısal hızı, projected gravity, hız komutu, varsayılana göre joint konumları, joint hızları ve önceki action; her biri sabit bir ölçekle. Reach observation’ımız aynı yapıda: , , , önceki action. İki değişikliği test ediyoruz: hızları çıkarmak ve hedefi gripper’a göre değil mutlak konum olarak vermek.
Daha derine: Proximal Policy Optimization (PPO); MuJoCo · actuator’ler; legged_robot.py.
Sıfırdan yaz
Bölüm başlığı “Sıfırdan yaz”Şimdi policy ile robot arasındaki arayüzü yazacaksın: action eşlemesi, servonun PD yasası, ölçerleriyle birlikte decimation döngüsü ve kontrol hızıyla neyin değiştiği. Her adım MuJoCo’ya ya da dersin ReachEnv’ine karşı kontrol ediliyor; hiçbir şey eğitilmiyor ve script yaklaşık 3 s sürüyor.
Fonksiyonlar physai/rl.py içinde; uv run python experiments/34-observation-action-design/build.py beş adımın hepsini koşturur (çıktı build_output.txt dosyasında).
Adım 1 · Policy çıktısından actuator komutuna
Bölüm başlığı “Adım 1 · Policy çıktısından actuator komutuna”def action_to_ctrl(a, mode, q_home, scale, ctrl_prev, lo, hi, tau_max=2.94): """Map a policy output in [-1, 1] to the actuator command: absolute target, delta target or torque.""" a = np.clip(a, -1.0, 1.0) if mode == "position": return np.clip(q_home + scale * a, lo, hi) if mode == "delta": return np.clip(ctrl_prev + scale * a, lo, hi) return tau_max * scale * a # "torque": the policy is the controllerKontrol, ReachEnv’i her modda ‘in biraz dışına taşan rastgele action’larla sürer ve onun komutunu seninkiyle karşılaştırır:
== Step 1. Policy output -> actuator command, 3 episodes of random actions per mode ==position (scale 1.0): max |ours - ReachEnv's command| = 0.0e+00 delta (scale 0.1): max |ours - ReachEnv's command| = 0.0e+00 torque (scale 1.0): max |ours - ReachEnv's command| = 0.0e+00Adım 2 · Servo bir hedefle ne yapar
Bölüm başlığı “Adım 2 · Servo bir hedefle ne yapar”def pd_torque(q_star, q, qd, kp, kd, tau_max): """What a position servo does at every physics step: a PD law towards the target, clipped to its torque limit.""" return np.clip(kp * (q_star - q) - kd * qd, -tau_max, tau_max)Gain’leri modelden oku, kolu hedefleri yaklaşık 3 mrad uzakta olan 1000 rastgele duruma koy ve MuJoCo’nun hesapladığı kuvvetle karşılaştır:
== Step 2. The servo's PD law vs MuJoCo, 1000 random states ==STS3215 in the Menagerie model: kp = 998.22 N m/rad, kv = 2.731 N m s/rad, force range +-2.94 N mmax |ours - data.actuator_force| = 3.2e-13 N m; 1885 of 4000 torques at the limita position error of 2.95 mrad alone saturates the servo (2.94 / 998.22)Senin PD yasan MuJoCo’nun position actuator’ünün kendisi (3,2e-13 N·m). kp = 998.22 ile 2,95 mrad uzaktaki bir hedef zaten tam 2,94 N·m istiyor, bu yüzden 4000 torkun 1885’i sınırda: Deney’in tork hızı sütununun ölçtüğü sertlik bu.
Adım 3 · Decimation ve iki ölçer
Bölüm başlığı “Adım 3 · Decimation ve iki ölçer”Fizik adım koşarken policy’nin komutu sabit tutulur; ölçerler fizik hızında örnekler:
def torque_rate_and_power(tau, qd, h):    """Smoothness and energy of one episode at the physics rate.
    tau: (N + 1, n) actuator torques, starting with the one before the first step; qd: (N, n) joint velocities    after each step; h: physics time step. Returns (RMS of ||d tau / dt|| [N m/s], mean sum |tau qdot| [W]).    """    rate = np.diff(tau, axis=0) / h    return np.sqrt(np.mean(np.sum(rate ** 2, axis=1))), np.mean(np.sum(np.abs(tau[1:] * qd), axis=1))
for _ in range(own.frame_skip): # the command is held for k physics steps mujoco.mj_step(own.model, own.data) taus.append(own.data.actuator_force[own.act].copy()) qds.append(own.data.qvel[own.vadr].copy())== Step 3. Decimation and the physics-rate recorder: one episode per mode (position: scripted IK; torque: a = 0.1) ==position: 320 physics steps; torque rate 345.9 N m/s (ReachEnv 345.9), power 1.713 W (ReachEnv 1.713) torque: 320 physics steps; torque rate 6.6 N m/s (ReachEnv 6.6), power 0.138 W (ReachEnv 0.138)Senin döngün ve ölçerlerin iki modda da ReachEnv’in kaydedicisini yeniden üretiyor. Tek bir scripted IK uzanması bile Deney A’daki farkı gösteriyor: sert servodan 345,9 N·m/s, sabit bir tork için 6,6 N·m/s.
Adım 4 · Kontrol hızı discount’u ve deneyimi değiştirir
Bölüm başlığı “Adım 4 · Kontrol hızı discount’u ve deneyimi değiştirir”def discount_for_rate(dt, horizon_s=0.4): """The discount that keeps a fixed look-ahead in seconds when the policy period dt changes.""" return 1.0 - dt / horizon_s== Step 4. Policy rate: gamma = 1 - dt / 0.4 s, and 300,000 policy steps in simulated time ==frame_skip rate Hz gamma simulated time 1 200.0 0.9875 25 min 2 100.0 0.9750 50 min 4 50.0 0.9500 100 min 8 25.0 0.9000 200 min 16 12.5 0.8000 400 minBunlar B bölümünün sütunu; son sütun onun karıştırıcı etkeni: 300.000 policy adımı 200 Hz’de 25 dk, 50 Hz’de 100 dk, 12,5 Hz’de 400 dk simüle zaman ediyor.
Adım 5 · Neyin ulaşılabilir olduğuna action ölçeği karar verir
Bölüm başlığı “Adım 5 · Neyin ulaşılabilir olduğuna action ölçeği karar verir”Scripted IK controller’ı iki ölçekte de aynı kesilmiş arayüzden, evaluation seed’lerinde gönder:
== Step 5. Action scale: scripted IK through the same clipped interface, 100 episodes (seeds 10000-10099) ==scale 1.00 rad: reaches 100/100scale 0.25 rad: reaches 27/100joint vectors drawn by the target sampler that lie within q0 +- 0.25 rad on all 4 joints: 1.8 %1,0 rad’da 100/100, 0,25 rad’da 27/100: Boz’un referans sayıları. Hedef örnekleyicinin çektiği joint vektörlerinin yalnızca %1,8’i dört eklemin hepsinde rad içinde kalıyor (); IK daha fazlasına ulaşıyor (%27), çünkü başka eklem kombinasyonları aynı noktaların bir kısmına varıyor, ama policy ne öğrenirse öğrensin hedeflerin çoğu action uzayının dışında.
Elinde kalan
Bölüm başlığı “Elinde kalan”physai.rl artık action_to_ctrl, pd_torque, torque_rate_and_power ve discount_for_rate’i de içeriyor. Ders 36 Go2’de aynı PD hedef arayüzünü kullanıyor, ders 37 ise komutla actuator arasına bir gecikme ekliyor. tests/test_34_observation_action_design.py modları, MuJoCo’ya karşı PD yasasını ve ölçerleri elle hesaplanmış bir örnekte kontrol ediyor; uv run pytest tests/test_34_observation_action_design.py çalıştır.
Kütüphaneyle kullan
Bölüm başlığı “Kütüphaneyle kullan”MuJoCo’da arayüz Python’da değil modelde seçilir: kp ve kv’li bir <position> actuator’ü Adım 2’nin PD servosudur, bir <motor> düz bir torktur ve forcerange clip’tir (XML referansı, actuator’ler). Dersin tork modu, servoları motora çevirmek için modelin gain ve bias parametrelerini yeniden yazar (ReachEnv.__init__ içinde). Unitree’nin training kodu ise PD torkunu üç modun hepsi için decimation döngüsünün içinde kendisi hesaplar (legged_robot.py · _compute_torques):
| Arayüz | Bu ders | MuJoCo modeli | legged_gym control_type |
|---|---|---|---|
| mutlak hedef | "position", | <position kp=... kv=...> | "P": |
| hız hedefi | kullanılmıyor | <velocity kv=...> | "V": |
| tork | "torque", | <motor> | "T": |
| tork sınırı | forcerange = ±2,94 N·m | forcerange | torch.clip(torques, -torque_limits, torque_limits) |
| PD hızı | her 5 ms’lik fizik adımında | her fizik adımında | range(decimation)’ın her adımında |
Üç tuzak:
- Modeldeki gain’ler eğittiğin gain’lerdir. Gerçek bir servonun iç döngüsü
kp = 998.22değildir; sert simüle servoya yaslanan bir policy donanımda farklı davranabilir (Bölüm 9). - Ölçek aynı zamanda gürültüdür. Action ölçeği keşif gürültüsünü çarpar (Matematik ayrıntısı); bir robotun ölçeğini kopyalamak onun keşfini de kopyalar.
- Hızı değiştirmek ‘nın anlamını değiştirir. Ufku
discount_for_rateile saniye cinsinden sabit tut ve bütçenin policy adımı mı yoksa simüle zaman mı olduğuna karar ver (Adım 4).
Yazdıktan sonra · 2 soru.
1. Sıfırdan yaz, Adım 2’de eklemden yalnızca 2,95 mrad uzaktaki bir hedef bile tam 2,94 N·m istiyor. Her 20 ms’de yeni bir mutlak hedef gönderen policy için bu ne demek?
- Hemen her yeni hedef, policy ne yaparsa yapsın, sınırda ya da ona yakın bir tork basamağı, bang-bang bir örüntü üretir.
- Servo 3 mrad’dan yakın hedefleri yok sayar.
- Kol adım başına en fazla 2,95 mrad hareket eder.
Neden: 2,94 / 998,22 = 2,95 mrad; hedefleri yaklaşık 3 mrad uzakta olan 1000 rastgele state’te 4000 torkun 1885’i sınırdaydı. Bu yüzden hedeflerde tork hızı 1002 N·m/s, torklarda 70.
2. Policy’yi 50 Hz’ten 200 Hz’e alıyorsun; 300.000 policy adımı bütçesini ve 0,4 s ufkunu koruyorsun. Hangi iki şey değişir?
- Hiçbir şey; ufuk da bütçe de sabit.
- 0,4 s’yi korumak için 0,9875’e çıkmalı ve policy 100 dk yerine 25 dk simüle edilmiş zaman görür.
- 0,8’e düşmeli ve policy dört kat daha çok simüle edilmiş zaman görür.
Neden: Sıfırdan yaz, Adım 4, s; 200 Hz’te Deney bu karıştırıcı etken varken 96/300 aldı, 50 Hz’te 298/300.
experiment.py her hücre için ders 33’ün PPO’sunu (aynı config, 300k policy adımı) eğitir: 3 seed × 100 evaluation episode’u. Evaluation sırasında env, fizik hızında torkun ne kadar hızlı değiştiğini (sarsıntılı komutlar) ve eklemlerin ne kadar mekanik güç kullandığını kaydeder:
Env bunları Sıfırdan yaz, Adım 3’teki gibi kaydeder; action modları Adım 1’in action_to_ctrl’üdür.
Tahmin edin: üç arayüzden hangisi 300k adımda en çok hedefe ulaşır, hangisi en yumuşaktır?
MuJoCo 3.17.0, NumPy 2.5.4, PyTorch 2.14.1 (CPU), Apple Silicon Mac (Apple M5). Başarı sayıları seed başına deterministik; training süreleri, yoğun yüklü paylaşılan bir makinede altı run paralel koşarken ölçülen duvar saati süreleridir (script’in tamamı, 30 run, 1190 s, yaklaşık 20 dakika sürdü). python experiment.py --only A:torque,D:0.25 yalnızca o hücreleri üç seed’le eğitir; bu tekrar çalıştırma iki satırı da aynen üretti (süre sütunu hariç). --quick yalnızca seed 0’ı eğitir: her satırın ilk “seed başına başarı” girdisini yeniden üretir, toplam sütunlarını değil.
A. Action parametrizasyonu (50 Hz, 3 seed × 100 episode):
| action | seed başına başarı | toplam | Wilson %95 | son mesafe (mm) | tork hızı (N·m/s) | güç (W) |
|---|---|---|---|---|---|---|
| mutlak hedef (PD) | 100 / 98 / 100 | 298/300 | %97,6–99,8 | 7,5 | 1002 | 9,66 |
| delta hedef (PD) | 95 / 88 / 99 | 282/300 | %90,7–96,2 | 8,7 | 980 | 8,81 |
| tork N·m | 83 / 93 / 96 | 272/300 | %86,8–93,5 | 7,6 | 70 | 1,87 |
(Son mesafe: medyan son mesafenin seed’ler üzerinden ortalaması.) Bütçe içinde en iyi mutlak hedefler öğreniyor. Delta hedefler ve tork daha düşük çıkıyor ama aralıkları örtüşüyor, bu yüzden o ikisini sıralamıyoruz; hücre başına üç seed’le aralıklar seed’ler arası değişkenliği de olduğundan küçük gösterir. Tork policy’si bir mertebe daha yumuşak (70’e karşı 1002 N·m/s) ve çok daha az mekanik güç kullanıyor (1,87’ye karşı 9,66 W). Bu, policy’yi değil servoyu işaret ediyor: 2,95 mrad’lık bir konum hatası onu zaten doyuruyor (Sıfırdan yaz, Adım 2); böylece 50 Hz’deki her yeni hedef neredeyse bang-bang bir tork basamağı üretiyor. Bir PD arayüzü ancak gain’leri kadar naziktir; Unitree’nin Go2’deki training PD’si buna kıyasla yumuşaktır ( N·m/rad).
B. Policy hızı (mutlak hedefler, s, aynı 300k policy adımı):
| frame_skip | policy hızı | seed başına başarı | toplam | Wilson %95 | tork hızı | güç | training s | |
|---|---|---|---|---|---|---|---|---|
| 1 | 200 Hz | 0,9875 | 37 / 33 / 26 | 96/300 | %27,0–37,5 | 1720 | 6,33 | 100 |
| 2 | 100 Hz | 0,9750 | 71 / 84 / 100 | 255/300 | %80,5–88,6 | 1305 | 7,79 | 134 |
| 4 | 50 Hz | 0,9500 | 100 / 98 / 100 | 298/300 | %97,6–99,8 | 1002 | 9,66 | 125 |
| 8 | 25 Hz | 0,9000 | 87 / 72 / 76 | 235/300 | %73,3–82,6 | 751 | 13,54 | 245 |
| 16 | 12,5 Hz | 0,8000 | 33 / 35 / 13 | 81/300 | %22,3–32,3 | 567 | 19,54 | 359 |
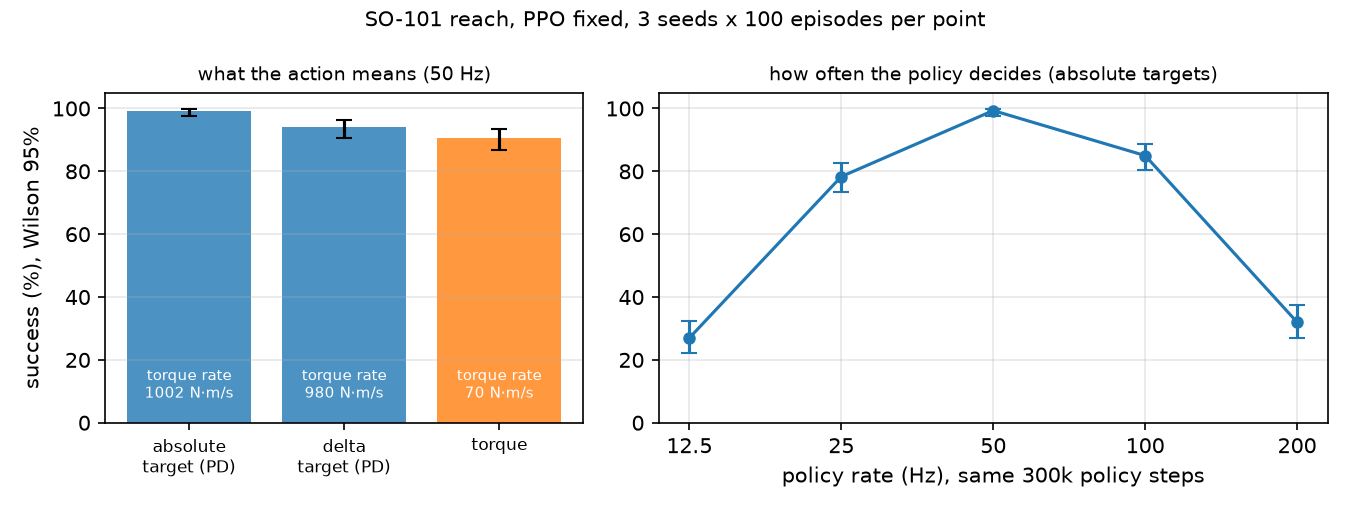
Bir optimum var ve Go2 config’inin durduğu yerde duruyor. İki etki buluşuyor. Sabit sayıda policy adımında 200 Hz’lik bir policy, 50 Hz’lik olanın simüle zamanının (ve episode’larının) yalnızca dörtte birini görür ve aynı ufuk için credit assignment’ı (sonraki bir reward’a hangi önceki action’ın yol açtığını çözmek) 4 kat daha fazla adıma yayılır. 12,5 Hz’de her karar 80 ms tutulur, policy bir hareketin içinde düzeltme yapamaz ve güç artar (19,54 W); bu, sert servonun daha büyük hedef sıçramalarını kovalamasıyla tutarlıdır. Simüle saniye cinsinden bir bütçe 200 Hz’lik policy’ye dört kat daha fazla deneyim verirdi (Sıfırdan yaz, Adım 4); o varyantı çalıştırmadık.
C. Observation içeriği (mutlak hedefler, 50 Hz):
| observation | seed başına başarı | toplam | Wilson %95 | son mesafe (mm) |
|---|---|---|---|---|
| tam: , , hedef − gripper, önceki action | 100 / 98 / 100 | 298/300 | %97,6–99,8 | 7,5 |
| joint hızları olmadan | 77 / 68 / 80 | 225/300 | %69,8–79,6 | 14,4 |
| hedef − gripper yerine mutlak hedef | 26 / 40 / 35 | 101/300 | %28,6–39,2 | 27,7 |
En önemli tek girdi göreli hedef: mutlak hedef konumuyla policy, yalnızca hangi yöne gideceğini bilmek için forward kinematics öğrenmek zorunda kalıyor ve başarı üçte bire düşüyor. Hızları çıkarmak başarıların yaklaşık dörtte birine mal oluyor: olmadan policy hareketi yalnızca dolaylı olarak (önceki action’ından) çıkarabilir, bu yüzden gelmekte olan bir eklemi uzaklaşmakta olandan güvenilir biçimde ayıramaz. Go2 observation’ı da gövde ve joint hızlarını içerir.
Go2’nin action ölçeğini, 0,25 rad’ı kola kopyalayın:
| ölçek | seed başına başarı | toplam | Wilson %95 | son mesafe (mm) |
|---|---|---|---|---|
| 1,0 rad | 100 / 98 / 100 | 298/300 | %97,6–99,8 | 7,5 |
| 0,25 rad | 9 / 8 / 4 | 21/300 | %4,6–10,5 | 62,6 |
Aynı kesilmiş arayüzden gönderilen scripted IK controller, ölçek 1,0’da 100/100 hedefe, 0,25’te ise yalnızca 27/100 hedefe ulaşıyor. Yani başarısızlık PPO’nun değil: hedefler ‘dan 0,6–1,0 rad uzağa kadar örnekleniyor ve ile policy en fazla rad komut edebiliyor; hedeflerin çoğu action uzayının dışında kalıyor. Scripted controller’ın 27/100’ü kesin bir tavan değil, bir referanstır (IK, clip altında optimal değildir). Go2’nin 0,25’i çalışır çünkü bir trot varsayılan poz yakınında kalır; ölçek görevin gerektirdiği hareketi kapsamalı, fazlasını değil, çünkü keşif gürültüsünü de çarpar.
Gerçek robotta
Bölüm başlığı “Gerçek robotta”- SO-101’deki STS3215 kendi konum döngüsünü çalıştırır; bu yüzden gerçek kolda “mutlak hedef” arayüzü doğal olanıdır: policy hedef konumları servo bus’ı üzerinden yazar. Modelin kendi yorumu, gain’lerinin gerçek kolda kullanılan servo gain’lerinin bire bir karşılığı olmadığını söyler (
so101.xml); yani simüle kapalı döngü bir yaklaşıklıktır. Tork modu akım kontrolü gerektirirdi; bu ders onu donanımda test etmedi. - Go2 için training PD’si (20 / 0,5) ile Unitree’nin gerçek robot ayağa kalkma örneği (Kp 60, Kd 5,
go2_stand_example.py) farklıdır; bir gain setiyle eğitilen policy o kapalı döngü için eğitilmiştir (ders 12). - Buradaki yumuşaklık sayıları ideal bir actuator’le alınmış simülasyon sonuçlarıdır. Gerçek kolun tork hızı ölçülmedi.
Kendini dene
Bölüm başlığı “Kendini dene”Hızlı kontrol · 2 soru. Bir cevaba tıkla.
1. Mutlak joint hedefleri en iyi öğrendi (298/300), ama torque rate’leri ham torque’un 70 N·m/s’sine karşı 1002 N·m/s idi. Sarsıntı nereden geliyor?
- Hedef policy’si torque policy’sinden daha fazla gürültüyle keşfeder.
- Simüle edilen servo çok sert; bu yüzden her yeni 50 Hz hedefi neredeyse bang-bang bir torque adımı üretir.
- 5 ms’lik physics timestep’i bir PD döngüsü için fazla büyük.
Neden: A bölümü: kp = 998.22 ve 2,94 N·m sınırla 3 mrad’lık bir konum hatası bile actuator’ı doyuma ulaştırır. Bir PD arayüzü ancak gain’leri kadar yumuşaktır.
2. Go2’nin 0,25 rad’lık action scale’i ile PPO hedeflerin 21/300’üne ulaştı. Aynı arayüzden geçen scripted IK’nın sonucu (27/100) neyi gösteriyor?
- PPO’nun küçük scale’de daha fazla training adımına ihtiyacı vardı.
- Küçük scale’ler her zaman daha yumuşak ve daha iyi policy’ler verir.
- Başarısızlık PPO’nun değil; hedeflerin çoğu policy’nin komut verebileceği en uzak nokta olan rad’ın dışında.
Neden: Boz bölümü. Hedefler ‘dan 0,6–1,0 rad’a kadar örneklenir; scale 1,0’da aynı scripted IK 100/100’e ulaşır. Scale’i görevin gerektirdiği harekete göre seçin.
- Kolay. Go2 config’inde action’ı, ön sol thigh için (varsayılan 0,8 rad) hangi joint hedefini verir? Eklem hâlâ 0,8 rad’da ve durağansa PD ne kadar tork üretir?
- Orta. Env’de SO-101 servo gain’ini düşürün (ör.
kp = 100, damping oranını korumak içinkv’yi ölçekleyin) ve mutlak hedefler için A bölümünü tekrar çalıştırın. Çalıştırmadan önce tork hızının ve başarının yönünü tahmin edin. - Zor. B bölümünü policy adımı yerine simüle saniye cinsinden bir bütçeyle tekrarlayın (ör. her hız için 1500 s deneyim). 200 Hz’lik policy yetişiyor mu? Başarıyı 3 seed için Wilson aralıklarıyla raporlayın.
Cevaplar
Bölüm başlığı “Cevaplar”- rad; N·m.
- Açık; çalıştırmadık. Daha düşük bir tork hızı bekleyin (hedef basamağı başına daha küçük tork); başarının korunup korunmayacağı, yumuşak servonun omuzdaki yerçekimini hâlâ yenip yenemeyeceğine bağlı.
- Açık; çalıştırmadık.
Akılda kalanlar ve kaynaklar
Bölüm başlığı “Akılda kalanlar ve kaynaklar”- PD döngüsüyle takip edilen joint hedefleri en iyi öğrenildi (298/300); ham torklar daha az öğrenildi (272/300) ama bir mertebe daha yumuşaktı, çünkü simüle servo çok sert. Arayüzü ve gain’leri birlikte seçin.
- Policy hızının bir optimumu var (burada 50 Hz: aynı adım bütçesiyle 298/300, 200 Hz’de 96/300, 12,5 Hz’de 81/300) ve hız değişince yeniden ayarlanmalı.
- Görevin gerektirdiğini observation’a, policy’nin hareket ettiği çerçevede koyun: mutlak hedef yerine hedef − gripper başarıyı 101/300’den 298/300’e çıkardı. Action ölçeğini göreve göre seçin: 0,25 rad kolu 21/300’de tuttu.
Sıradaki: ders 35, reward’un ne istediği ve agent’ın onunla ne yaptığı.
Kaynaklar
unitree_rl_gym·go2_config.py,legged_robot.py(_compute_torques,compute_observations),legged_robot_config.py(BSD-3-Clause).unitree_sdk2_python·go2_stand_example.py.- MuJoCo · XML referansı, actuator’ler (position actuator = fizik adımının içinde PD).
- MuJoCo Menagerie ·
robotstudio_so101(Apache-2.0). - J. Schulman vd., “Proximal Policy Optimization Algorithms”, 2017. arXiv 1707.06347
- Kod:
experiment.py,output.txt; env ve PPO ders 32 ve ders 33’ten; şekilplot.pyile üretildi.