31 · Action chunking ve ACT
| Bölüm | 7 · Learning from demonstration |
| Çalışma türü | CPU · Mac ya da Colab CPU |
| Önkoşul | 28, 30 |
| Önce öğren | The Full Transformer — Encoder + Decoder · Autoencoders & Variational Autoencoders (VAE) |
| Süre | ~75 dk |
| Kod | experiments/31-act/experiment.py |
| Durum | ✅ tam |
Bu derste yap
Her adımı yapınca işaretle. Yalnız bu tarayıcıda saklanır.
Bir sonraki action’ı değil, sonraki k action’ı tahmin et: chunk, observation’ın süresini ölçemediği bir beklemenin ötesine uzanabilir.
Problem
Bölüm başlığı “Problem”Bir behavior cloning policy’si şimdiki observation’ı bir sonraki action’a eşler, ama gösterimlerde bazen observation aynı kalırken doğru action zamanla değişir: kol, gripper kapanırken bekler, sonra yoluna devam eder. ACT makalesi (Action Chunking with Transformers, Zhao vd. 2023, Böl. I), action dizilerini tahmin etmenin “temporally correlated confounders” ile, örneğin gösterimlerdeki duraklamalarla başa çıkmaya yardım ettiğini söyler. Chunk boyutu ablation’ında (Şek. 8a, ensembling yok) başarı ‘de %1’den ‘de %44’e çıkıyor.
Bizim sürümümüz, simülasyonda: düzlemsel bir kol hedefe gider, 0,5 s hareketsiz bekler, sonra bir bırakma noktasına gider. 100 gösterimle eğitilmiş tek adımlık bir policy, 600 episode’un 543’ünde hedefte takılı.
Okumadan önce · 2 soru. Önce tahmin et; nedenini ders anlatıyor.
1. policy’si neden geç ayrılmak yerine hedefte kalıyor?
- Network’ü ayrılışı temsil edemeyecek kadar küçük.
- Torque bozucusu kolu sürekli hedefe geri itiyor.
- Hedefin üstünde dururken gösterilen bir sonraki action, sonuncusu hariç her bekleme adımında “bekle”dir; L1-optimal çıktı olan medyan da “bekle”dir.
Neden: Deney tablosu: ‘de 600 episode’un 543’ü takılı; observation’ında zamanlayıcı da faz da yok.
2. Bir policy her adımda sonraki 32 action’ı tahmin ediyor ve sen her birinin yalnızca ilkini uyguluyorsun. Diğer tahminleri şimdiki adım için nasıl kullanabilirsin?
- Önceki sorguların bu adım için yaptığı tüm tahminlerin ortalamasını al, eskilere biraz daha çok ağırlık ver.
- Onları yok say; yalnızca en yeni tahmin doğru olabilir.
- 32’sini birden uygula.
Neden: Bu temporal ensembling’dir, , ve en eskisi; ‘de en iyi satırı verdi, 552/600 (%92,0).
Ana fikir
Bölüm başlığı “Ana fikir”Sade anlatımla
Bölüm başlığı “Sade anlatımla”Geri sayımı olmayan bir kırmızı ışıkta bekleyen acemi bir sürücü düşün: beklemenin her saniyesi aynı görünür. Yalnızca “bu sahnede bir sonraki hamlem ne?” sorusunu öğrenen bir öğrenci örneklerin neredeyse hepsinde “bekle” görür, çünkü “git” bir kez, en sonda olur; ve sonsuza kadar beklemeyi öğrenir. Zamanlama şimdiki observation’da değil, geçmiştedir.
Action chunking sonraki hamleye birden bağlanır, örneğin “bekle, bekle, bekle, git, git”; plan ayrılış anını içerecek kadar uzunsa kol ayrılır. Daha az karar, hataların birikmesi için daha az fırsat da demektir (ders 29).
Bir chunk’ı uygulamanın iki yolu: open-loop, action’ın hepsini bakmadan oynat, sonra yeniden sor; temporal ensembling, her adımda sor ve örtüşen bütün planların şimdi için verdiği tavsiyeyi ortala, eski planlara biraz daha çok güvenerek. İlki bağlanır; ikincisi tepki verir ve yumuşatır, ama ortalama almak ayrılma kararını sulandırabilir.
flowchart TD
    O["observation o_t"] --> P["policy bir chunk tahmin eder:<br/>t ... t+k-1 action'ları"]
    P --> Q{"uygulama şeması"}
    Q -->|"open-loop"| C["k action'ın hepsini oynat,<br/>sonra yeniden sorgula"]
    Q -->|"temporal ensembling"| B["gelecek her adım için<br/>en fazla k tahmin sakla"]
    B --> W["t adımı için ağırlıklı ortalama<br/>(eski olan daha ağır)"]
    C --> R["robot"]
    W --> R
Chunking ve ensembling kod olarak
Bölüm başlığı “Chunking ve ensembling kod olarak”# dataset: one observation -> the next k actions (episode end padded with the last action)X = [o[t] for t in range(T)]Y = [a_pad[t:t + k] for t in range(T)] # shape (k, n_joints); trained with L1 loss
# open-loop: query once every k stepsif t % k == 0: chunk = policy(obs)action = chunk[t % k]
# temporal ensembling: query every step, average every prediction made for step tchunks[t] = policy(obs) # chunks[s][j] predicts step s + jdef ensembled_action(chunks, t, k, m=0.01): preds = [chunks[s][t - s] for s in range(max(0, t - k + 1), t + 1)] # oldest first w = [exp(-m * i) for i in range(len(preds))] # i = 0 is the oldest return sum(wi * p for wi, p in zip(w, preds)) / sum(w)| Ne | Formül |
|---|---|
| Tek adımlık policy | |
| Chunk’lı policy | |
| Temporal ensembling | |
| L1 optimumu | o observation için gösterilen action’ların boyut boyut medyanı |
, adımındaki observation; action; chunk boyutu; , adımı için yapılmış . tahmin ( en eskisi); onun ağırlığı ve ağırlığın ne kadar hızlı azaldığıdır ( düz bir ortalamadır).
Matematik ayrıntısı: L1 neden sonsuza kadar bekletir ve chunk nasıl kurtulur
Bekleme tek adımlık policy’yi neden bozar. Bekleme boyunca observation neredeyse hiç değişmez ve bir sonraki action, sonuncusu hariç her bekleme adımında “bekle”dir. ACT’nin L1 loss’unu boyut boyut medyan minimize eder: bekle, sonsuza kadar. L2 ortalamayı, yani yavaş bir sürünmeyi verirdi (ders 30).
Chunk neden kurtulabilir. O observation’dan tahmin edilen bir chunk’ın . elemanı, gösterimlerin ile büyüyen bir kısmında “çoktan hareket ediyor”dur; bu kısım yarıyı geçince medyan hareket eder (Sıfırdan yaz, Adım 2).
Daha az karar. Her adımda bir sorgulamak görevin etkin ufkunu kat kısaltır (Böl. I): hataların birikebileceği daha az adım.
Ensembling ağırlıkları. ve en eski tahmin olduğundan eski tahminler daha ağırdır; “a smaller m means faster incorporation”, yani küçük yeni observation’ları daha hızlı dahil eder (Böl. IV-A). Makale için bir değer vermiyor; LeRobot’un config yorumu orijinalin kullandığını söylüyor. Herhangi bir adım için en fazla tahmin vardır.
Daha derine (AIEFS): The Full Transformer — Encoder + Decoder, Autoencoders & Variational Autoencoders (VAE). Birincil kaynak: Zhao vd. 2023, Böl. I ve IV.
Bir chunk’ı uygulamanın iki yolu
Bölüm başlığı “Bir chunk’ı uygulamanın iki yolu”| open-loop chunk’lar | temporal ensembling | |
|---|---|---|
| sorgu | her adımda | her adımda |
| adımındaki action | son chunk’ın . elemanı | için tahmin edilmiş tüm chunk elemanlarının ağırlıklı ortalaması |
| bozucuya tepki | chunk başına bir kez | her adımda |
| chunk sınırları | sıçrar | yumuşar |
ACT’nin mimarisi
Bölüm başlığı “ACT’nin mimarisi”ACT bir transformer ve eğitim sırasında gösterilen chunk’ı küçük bir “stil” vektörü ‘ye sıkıştıran bir CVAE (conditional variational autoencoder) ekler; amaç aynı işi yapmanın farklı yollarını temsil etmek (Böl. IV):
| parça | ne yapar |
|---|---|
| CVAE encoder (yalnız eğitimde) | [CLS], joint pozisyonları ve gösterilen chunk üzerinde transformer → bir “stil değişkeni” için diyagonal Gauss |
| backbone | kamera başına ResNet18; dört 480×640 görüntü → 2D sinüzoidal pozisyon embedding’li 15×20×512 feature map’ler |
| transformer encoder | görüntü feature’ları + joint pozisyonları + , her biri 512 boyuta eşlenmiş |
| transformer decoder | cross-attention, ‘lük bir chunk verir (iki 7-DoF kol) |
| loss, inference | L1 reconstruction + KL; test zamanında (prior ortalaması), deterministik |
Yaklaşık 80M parametre, görev başına tek bir RTX 2080 Ti’da ~5 saat eğitim, 50 Hz, , gerçek görevlerin çoğunda 50 gösterim. CVAE hedefi olmadan başarı insan verisinde %35,3’ten %2’ye düştü, scripted veride pek değişmedi (Şek. 8c); ensembling %3,3 ekledi (Şek. 8b).
Sıfırdan yaz
Bölüm başlığı “Sıfırdan yaz”Şimdi ACT’nin Deney tablosunun dayandığı parçalarını yazacaksın: chunk hedefleri, bir beklemedeki L1 optimumu ve temporal ensembling. Ağ sıradan bir MLP, bu yüzden Sıfırdan yaz elle yapılmış chunk’larla çalışıyor; script bir saniyenin altında koşuyor.
Fonksiyonlar physai/imitation.py içinde; uv run python experiments/31-act/build.py dört adımı koşturur (çıktı build_output.txt dosyasında).
Adım 1 · Chunk hedefleri
Bölüm başlığı “Adım 1 · Chunk hedefleri”Her observation hedef olarak sonraki action’ı alır; episode’un sonundan sonra son action tekrarlanır:
def chunk_targets(actions, k): """Training targets of a chunked policy: for every step t the next k actions, padded with the last action.""" actions = np.asarray(actions) padded = np.concatenate([actions, np.repeat(actions[-1:], k - 1, axis=0)]) return np.stack([padded[t:t + k] for t in range(len(actions))])Beş rastgele episode’da Deney’in chunk_dataset’iyle karşılaştırılınca:
== Step 1. Chunk targets ==k = 1: targets (750, 1, 2), max |ours - Experiment| = 0.0e+00k = 4: targets (750, 4, 2), max |ours - Experiment| = 0.0e+00k = 32: targets (750, 32, 2), max |ours - Experiment| = 0.0e+00last step's chunk repeats the last action: TrueAdım 2 · Bir beklemedeki L1 optimumu
Bölüm başlığı “Adım 2 · Bir beklemedeki L1 optimumu”İdealleştirilmiş bir bekleme: kol 25 “bekle” komutu boyunca hedefte duruyor, sonra ilk “hareket et” (adım başına 0,12 rad) kol hâlâ durağanken geliyor. Yani 26 adım tek bir observation’ı paylaşıyor ve chunk’ları yalnız ayrılışın nereye düştüğünde farklı. L1’i eleman başına medyan, MSE’yi ortalama minimize eder:
traj = np.r_[np.zeros(25), 0.12 * np.arange(1, 41)] # target relative to the goal, from the first pause stepchunks = np.stack([chunk_targets(traj[:, None], 32)[j, :, 0] for j in range(26)])med, mean = np.median(chunks, 0), chunks.mean(0)== Step 2. An idealized pause: 25 hold commands, then a move, all seen from the same resting observation ==entry i 0 4 8 12 13 16 24 31moving % 4 19 35 50 54 65 96 100median 0.000 0.000 0.000 0.060 0.180 0.540 1.500 2.340mean 0.005 0.069 0.208 0.420 0.485 0.706 1.500 2.340single-step policy (entry 0): median 0.000 rad = hold forever, mean 0.0046 rad = a creepfirst entry whose median departs: 12; chunks of k <= 12 are all 'hold'Eleman 0 tek adımlık policy’dir: medyan 0, sonsuza kadar bekle; ortalama 0,0046 rad, bir sürünme (Matematik ayrıntısı). . eleman 26 chunk’ın ‘inde ayrılıyor, bu yüzden medyanı yarıda döner: eleman 12’de yarım adım, 13’ten itibaren tam adım. olan bir chunk baştan sona “bekle”dir; daha uzun chunk’lar bekler, sonra ayrılır. Deney’in eğitilmiş policy’leri daha erken, eleman 8–9’da ayrılıyor. Olası bir sebep (ölçülmedi): gösterici sayacını hedefe 1 cm kala başlatıyor, bu yüzden ilk bekleme adımları “durağan” görünmüyor ve medyanı daha az observation paylaşıyor.
Adım 3 · Temporal ensembling, iki yoldan
Bölüm başlığı “Adım 3 · Temporal ensembling, iki yoldan”Ana fikir’deki formül, saklanan chunk’ların bir listesi için yazılmış hâliyle (chunks[s][j], adımını tahmin eder):
def ensembled_action(chunks, t, k, m=0.01):    """Temporal ensembling (ACT): weighted mean of every prediction made for step t; chunks[s][j] predicts s + j.
    Weights w_i = exp(-m i) with i = 0 the oldest prediction, so older predictions weigh more for m > 0.    """    preds = [chunks[s][t - s] for s in range(max(0, t - k + 1), t + 1)]   # oldest first    w = np.exp(-m * np.arange(len(preds)))    return np.tensordot(w, np.array(preds), axes=1) / w.sum()
Bir robot aynı ortalamayı, her yeni chunk için bir güncellemeyle, birikimli bir toplam olarak tutar:
class TemporalEnsembler:    """The same ensembling as a running average (one new chunk per step, O(k) memory)."""
    def __init__(self, k, m=0.01):        self.w = np.exp(-m * np.arange(k))       # w[i]: weight of the i-th prediction for a step, oldest first        self.cum = np.cumsum(self.w)        self.avg, self.count = None, None
    def update(self, chunk):        """Add the chunk predicted now (shape (k, n)); return the action to execute now."""        chunk = np.asarray(chunk, dtype=float)        if self.avg is None:            self.avg, self.count = chunk.copy(), np.ones(len(chunk), dtype=int)        else:                                    # entries 0..k-2 of the stored average are steps 1..k-1 of the new chunk            c = self.count            self.avg = (self.avg * self.cum[c - 1, None] + chunk[:-1] * self.w[c, None]) / self.cum[c, None]            self.avg = np.concatenate([self.avg, chunk[-1:]])            self.count = np.concatenate([np.minimum(c + 1, len(self.w) - 1), [1]])        action, self.avg, self.count = self.avg[0], self.avg[1:], self.count[1:]        return action
Kontrol, ‘lik 60 rastgele chunk’ı ikisine ve Deney’in biriktiricilerine verir (chunk ofseti için ağırlık , yani en eski tahmin en ağır):
== Step 3. Temporal ensembling, k = 32, m = 0.01, 60 steps of random chunks ==max |running average - list formula| = 2.8e-16max |Experiment's accumulators - list formula| = 2.8e-16full window: oldest weight 0.0363, newest 0.0266, ratio 1.363Üçü yuvarlama düzeyinde tutuyor. ile 32 tahminin en eskisi 0,0363, en yenisi 0,0266 ağırlık alıyor: eski planlara hafif bir tercih.
Adım 4 · Ensembling bir ayrılışı neden sulandırabilir
Bölüm başlığı “Adım 4 · Ensembling bir ayrılışı neden sulandırabilir”Deney’in ölçtüğü ayrılış indekslerini al (‘da 9, ‘de 8) ve durağanken yapılan her sorgunun aynı chunk’ı döndürdüğünü varsay: o elemana kadar bekle, sonra adım başına 0,12 rad. Open-loop chunk’ın tamamını oynatır; ensembling farklı zamanlarda tahmin edilmiş elemanları ortalar:
== Step 4. A chunk that departs at entry i0, queried again and again at rest ==(i0 = the Experiment's median first departure index; same chunk at every query; 0.12 rad per step after i0) k i0 weight on departing entries open-loop, entries i0 .. k-1 ensembled, at rest [rad from the goal] 16 9 0.46 0.12 .. 0.84 0.222 32 8 0.78 0.12 .. 2.88 1.213‘da ağırlığın yalnız %46’sı ayrılan elemanlarda ve ensembled hedef 0,222 rad oynuyor, open-loop’ta ise 0,12 ila 0,84 rad; ‘de %78 ve 1,213 rad. Bu bir idealleştirme altında aritmetik, simülasyon değil, ama tabloyla tutarlı: ensembled 600 episode’un 362’sinde takılı kaldı, ensembled hiçbirinde.
Elinde kalan
Bölüm başlığı “Elinde kalan”physai.imitation artık chunk_targets, ensembled_action ve TemporalEnsembler de içeriyor. tests/test_31_act.py dolgulamayı, birikimli ortalamanın birkaç ve için liste formülüne eşit olduğunu ve ‘ın eski tahminleri kayırdığını kontrol ediyor; uv run pytest tests/test_31_act.py çalıştır.
Kütüphaneyle kullan
Bölüm başlığı “Kütüphaneyle kullan”LeRobot’un ACT’sinde iki şema da var (configuration_act.py, modeling_act.py). Varsayılan olarak action kuyruğu boşaldığında modeli sorgular ve ilk n_action_steps action’ı oynatır: open-loop. Bir katsayı, her adımda sorguyla temporal ensembling’i açar:
from lerobot.policies.act.configuration_act import ACTConfigcfg = ACTConfig(temporal_ensemble_coeff=0.01, n_action_steps=1) # query every step, ensemble the chunks| Bu ders | LeRobot ACT | |
|---|---|---|
| chunk boyutu | 1 ila 32 | chunk_size, varsayılan 100 |
| sorgu başına open-loop adım | n_action_steps, varsayılan 100 | |
| ensembling hızı | 0,01 | temporal_ensemble_coeff, varsayılan None (kapalı); 0,01 “the value used in ACT” |
| ağırlıklar | , en eski | exp(-temporal_ensemble_coeff * arange(chunk_size)), en eski |
| birikimli güncelleme | TemporalEnsembler | ağırlıkların birikimli toplamıyla ACTTemporalEnsembler.update |
| CVAE | atıldı | use_vae = True, kl_weight = 10.0 |
Üç tuzak:
- Ensembling sorgu başına bir adım ister.
temporal_ensemble_coeff,n_action_steps > 1ile ayarlanırsa LeRobot hata verir. - ‘nin işareti. en eski tahmin olduğunda eski planları kayırır; en yeniden indeksleyen bir port bunu sessizce tersine çevirir.
- Chunk beklemeden uzun sürmeli. Durağan bir observation’dan, beklemenin yaklaşık yarısından kısa bir chunk baştan sona “bekle”dir (Adım 2; Boz: 0,64 s’lik chunk’la 1,5 s beklemede 196/200 takılı). LeRobot’un 30 fps’teki 100 adımı yaklaşık 3,3 s sürer.
Yazdıktan sonra · 2 soru.
1. Sıfırdan yaz, Adım 2’de 26 dinlenme adımı aynı gözlemi paylaşıyor ve kol 25. bekletmeden sonra ayrılıyor. Entry başına median (L1 optimumu) hangi chunk entry’sinden itibaren tam bir adım hareket eder?
- Entry 0’dan; median ortalamayı izler.
- Duraklamanın uzunluğu olan entry 25’ten.
- 26 chunk’ın yarısından fazlasının zaten hareket ettiği entry 13’ten.
Neden: Entry , 26 chunk’ın ‘inde ayrılır; entry 12’de tam yarısı ayrılır, bu yüzden median yarım adım (0,060 rad), 13’ten itibaren tam adım hareket eder. olan bir chunk tamamen “bekle”dir.
2. LeRobot’un ACT’sinde temporal_ensemble_coeff=0.01 ile temporal ensembling’i açıyorsun ve varsayılan n_action_steps=100’ü koruyorsun. Ne olur?
- 100 adım üzerinden ensemble yapar, bu daha yumuşaktır.
- Bir hata; ensembling sorgu başına tek action ister,
n_action_steps=1. - Katsayı yok sayılır ve chunk open-loop çalışır.
Neden: Kütüphaneyle kullan, tuzaklar. Ensembling’de model her adımda sorgulanır ve action’ı kayan ortalama (ACTTemporalEnsembler.update, Adım 3’teki TemporalEnsembler gibi) verir.
Script’in tamamı: experiments/31-act/experiment.py. MuJoCo 3.17.0, NumPy 2.5.4, PyTorch 2.14.1 (CPU, 2 thread), Apple Silicon Mac (Apple M5), deterministik seed’ler; output.txt’teki duvar saati süreleri yaklaşıktır.
Görev. 2 segmentli düzlemsel bir kol (0,30 m + 0,25 m, position servo’lar kp=20, kv=1.5), 50 Hz control, rastgele tork bozucusu (eklem başına 0,2 N·m standart sapma, her control adımında). Gösterici hedefin IK çözümüne doğru gider (öndelik 0,12 rad’da kırpılmış), 1 cm içinde sayacını başlatır, 25 adım (0,5 s) bekler, sonra sabit bir bırakma pozuna gider. Policy ‘ü görür, sayaç yok. 100 gösterim × 150 adım.
ACT’den korunan: mutlak joint hedeflerinden chunk’lar, L1 loss, ile iki uygulama şeması da. Atılan: görüntüler, transformer, CVAE (en az scripted veride önemliydi, bizimki gibi). Policy: MLP 6-256-256-, 3.000 Adam adımı, her ve eğitim seed’i için bir model (3 seed).
for t in range(len(o)):                                # dataset: o_t -> a_{t..t+k-1}    X.append(o[t]); Y.append(a_pad[t:t + k].reshape(-1))
w = np.exp(-m * (k - 1 - np.arange(k)))                # chunk offset j: older prediction, larger weightchunk = pol(obs)                                       # temporal ensembling: query every stepnum[:, t:t + k] += w[None, :, None] * chunkden[:, t:t + k] += w[None, :, None]a = num[:, t] / den[:, t]
Başarı: en az 0,2 s hedefin 3 cm içinde kalmak, sonra 4,0 s’de bırakma noktasının 3 cm içinde olmak; seed başına 200 yeni hedef, satır başına 600 episode, her satırda aynı bozucular. Hatalar: ıska (hedefe hiç ulaşmadı), kısa (0,2 s dolmadan ayrıldı), takılı (4,0 s’de hâlâ hedefte). Bekleme: başarılı episode’larda hedefte kalınan en uzun sürenin medyanı. Jerk: komut edilen joint hedeflerinin üçüncü farkının RMS’i (rad/s³).
Tahmin: küçük takılır; büyük open-loop chunk’lar çok seyrek tepki verir; ensembling yumuşatır.
| policy | başarı | %95 GA | ıska | kısa | takılı | bekleme (s) | jerk |
|---|---|---|---|---|---|---|---|
| gösterici | 200/200 | %98,1–100 | 0 | 0 | 0 | 0,66 | 3506 |
| 18/600 | %1,9–4,7 | 2 | 26 | 543 | 0,44 | 2443 | |
| open-loop | 20/600 | %2,2–5,1 | 0 | 27 | 535 | 0,33 | 1734 |
| ensembled | 14/600 | %1,4–3,9 | 1 | 23 | 545 | 0,59 | 677 |
| open-loop | 32/600 | %3,8–7,4 | 3 | 25 | 534 | 0,37 | 1694 |
| ensembled | 23/600 | %2,6–5,7 | 2 | 34 | 538 | 0,82 | 376 |
| open-loop | 431/600 | %68,1–75,3 | 62 | 87 | 6 | 0,48 | 3085 |
| ensembled | 160/600 | %23,3–30,3 | 5 | 1 | 362 | 0,81 | 543 |
| open-loop | 297/600 | %45,5–53,5 | 200 | 103 | 0 | 0,38 | 3875 |
| ensembled | 552/600 | %89,6–93,9 | 39 | 9 | 0 | 0,58 | 433 |
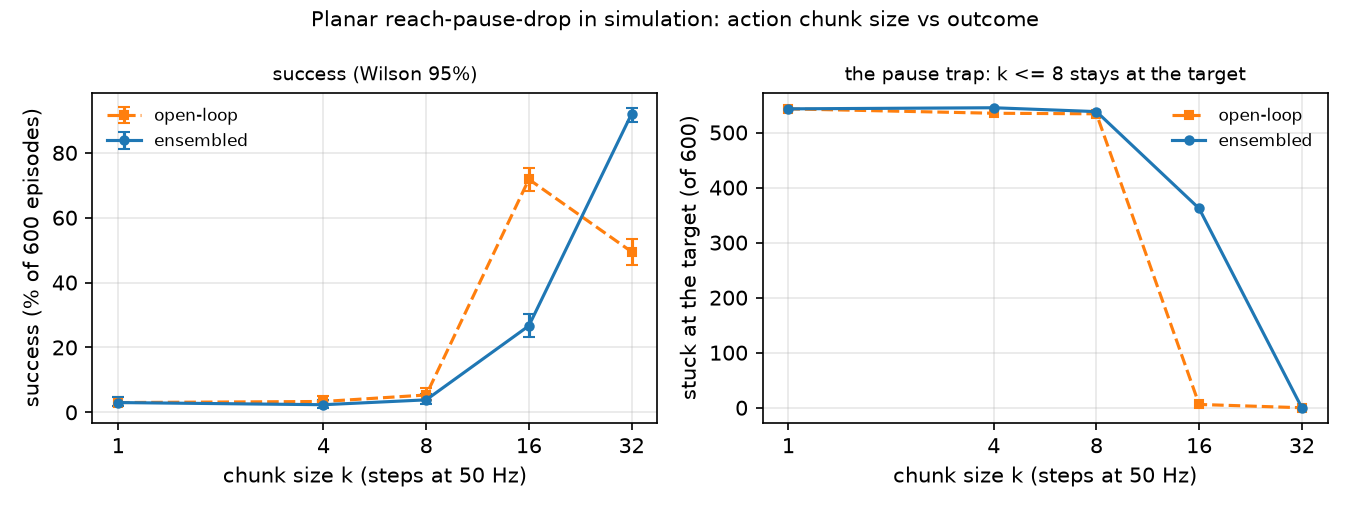
8 ile 16 arasındaki sıçrama neden? Her policy’yi (seed 0) 200 hedef için hedefin üstünde durağanken sorgula ve ondan 0,02 rad’dan fazla ayrılan ilk chunk elemanını bul:
| 1 | 4 | 8 | 16 | 32 | |
|---|---|---|---|---|---|
| ayrılış içeren chunk’lar | 0/200 | 0/200 | 8/200 | 200/200 | 200/200 |
| medyan ilk ayrılış indeksi | – | – | 6,0 | 9,0 | 8,0 |
Bekleme state’inden tahmin edilen chunk yaklaşık 8–9 adım bekliyor, sonra ayrılıyor (bir medyanın neden önce beklediğini Sıfırdan yaz, Adım 2 açıklıyor). Daha kısa bir chunk baştan sona “bekle”dir: , iki şemada da 600 episode’un 534–545’inde takılı kalıyor. Bunun üstünde şema belirleyici:
- open-loop (%71,8) chunk’ın tamamına bağlı kalır, ayrılış elemanları uygulanır. ensembled (%26,7) ayrılan elemanları (eski sorgular) bekleyen elemanlarla (aynı durağan state’teki yeni sorgular) ortalar. 362 takılı episode’la ve Sıfırdan yaz’ın Adım 4 hesabıyla tutarlı ama ölçülmemiş bir hipotez: ortalanmış komut bekleme state’inden çıkmaya yetecek kadar oynamıyor, sonraki sorgular yine “bekle” diyor.
- open-loop (%49,5) 600 episode’un 200’ünde hedefi ıskalıyor: kör uygulanan 0,64 s’lik komut, 3 cm’de bozucuyu düzeltemiyor. Aynı modelleri ensembling ile kullanmak %92,0 veriyor, en iyi satır.
- Jerk. Ensembling komut jerk’ünü her ‘da düşürüyor (‘te 1734 → 677, ‘de 3875 → 433), göstericinin (3506) bile altında.
Beklemeyi uzat; ensembled kalsın (seed 0, 200 episode, bütçe = bekleme + 3,5 s):
| bekleme | 0,5 s | 1,0 s | 1,5 s | 2,0 s |
|---|---|---|---|---|
| başarı | 185/200 | 65/200 | 2/200 | 0/200 |
| takılı | 0 | 1 | 196 | 154 |
Chunk 0,64 s’yi kapsıyor. Medyan argümanıyla tutarlı olarak: durağandan tahmin edilen bir chunk’ın sonunda gösterimlerin çoğu hâlâ bekliyorsa chunk baştan sona “bekle” olur ve kol hiç ayrılmaz (1,5 s’de 196/200 takılı). 1,0 s’de 200 episode’un 126’sı hedeften ayrıldı ama bütçe içinde bırakma noktasını ıskaladı (daha fazla ayrıştırılmadı). Chunk, gösterimlerdeki en uzun gözlenemeyen beklemeye göre uzun olmalı ya da eksik state (bir sayaç, gripper sinyali, geçmiş) observation’a girmeli.
Gerçek robotta
Bölüm başlığı “Gerçek robotta”- LeRobot.
lerobot-train --policy.type=act --dataset.repo_id=...ACT’yi eğitir. Dokümantasyon onu denenecek ilk policy olarak öneriyor (~80M parametre, tek GPU’da 100k eğitim adımı için birkaç saat); SO-101’de değerlendirmelerobot-rollout --robot.type=so101_follower ...ile (LeRobot ACT dokümanı). Varsayılanları Kütüphaneyle kullan’da; config yorumundan bir tane daha:n_decoder_layers=1, çünkü orijinal 7 ayarlıyor ama bir bug yüzünden yalnızca ilki kullanılıyor. - SO-101 prosedürü. Gripper kapanırken bilerek beklenen bir pick görevinin 50 episode’unu kaydet. ACT’yi varsayılanlarla eğit ve üç ayarı aynı 20+ nesne yerleşiminde değerlendir: varsayılanlar,
temporal_ensemble_coeff=0.01ilen_action_steps=1ve kısa birchunk_size. Başarıları ve takılı episode’ları Wilson aralıklarıyla say (ders 25). Gerçek kolda henüz ölçülmedi.
Kendini dene
Bölüm başlığı “Kendini dene”Hızlı kontrol · 2 soru. Bir cevaba tıkla.
1. Hedefin üstünde dururken tahmin edilen bir chunk, medyan olarak 8–9 civarındaki indekste ayrılıyor. Bu için ne demek?
- Chunk’larının hepsi “bekle”; bu yüzden iki şemada da 600 episode’un 534–545’inde takılı kalıyorlar.
- Hemen ayrılıyorlar, çünkü her chunk open-loop uygulanıyor.
- Temporal ensembling yine de ayrılmalarını sağlıyor.
Neden: Ayrılış tablosu: ve 4’te chunk’ların 0/200’ü, ‘de 8/200’ü, ve 32’de 200/200’ü bir ayrılış içeriyor.
2. ‘de open-loop episode’ların %49,5’inde, temporal ensembling %92,0’ında başarılı. Farkı ne açıklar?
- Open-loop hedefte daha sık takılıyor.
- Open-loop 0,64 s boyunca kör komut oynatıyor ve bozucuyu düzeltemiyor, bu yüzden 600 episode’un 200’ünde hedefi ıskalıyor; ensembling her adımda sorguluyor.
- Ensembling daha büyük bir network kullanıyor.
Neden: Deney tablosu, : open-loop 200 ıska ve 0 takılı, ensembled 39 ıska ve 0 takılı; ensembling jerk’ü de 3875’ten 433’e düşürüyor.
- Kolay. policy’si neden geç ayrılmak yerine hedefte kalıyor?
- Orta. Ölçülen ayrılış indeksi yaklaşık 9 iken ensembled neden takılabiliyor da open-loop ayrılıyor?
- Zor. Observation’a varıştan beri geçen süreyi ekle ve ‘i yeniden koş. Takılı sayısı düşüyor mu? O zaman chunking ne zaman gerekir?
Cevaplar
Bölüm başlığı “Cevaplar”- Hedefin üstünde durağanken gösterilen bir sonraki action, sonuncusu hariç her bekleme adımında “bekle”dir; L1-optimal çıktı olan medyan da “bekle”dir. Ölçülen: 543/600 takılı.
- Olası mekanizma (ölçülmedi): yalnızca en az ~9 adım önce yapılan tahminler ayrılışı içerir, bu yüzden ağırlıklı ortalama az oynar (Sıfırdan yaz, Adım 4: ağırlığın %46’sı, 0,222 rad) ve durağanken yapılan yeni sorgular “bekle” der. Open-loop ayrılışı karıştırmadan uygular. Ölçülen: 362/600’e karşı 6/600 takılı.
- Burada hesaplanmadı; koş ve gör.
Akılda kalanlar ve kaynaklar
Bölüm başlığı “Akılda kalanlar ve kaynaklar”- Observation’ın süresini ölçemediği bir bekleme, L1 ile eğitilmiş tek adımlık bir policy’yi sonsuza kadar bekletir (simülasyonda 543/600 takılı); chunk ancak öğrenilen beklemeyi (burada 8–9 adım) aşarsa onun ötesine uzanır.
- Open-loop chunk’lar bağlanır (‘da %71,8) ama seyrek tepki verir (‘de 200 ıska); ‘de ensembling en iyi sonucu (%92,0) verdi ve jerk’ü her ‘da düşürdü.
- Chunk, gözlenemeyen en uzun beklemeden uzun sürmeli: 0,64 s’lik chunk’la başarı 0,5 s beklemede 185/200’den 2,0 s’de 0/200’e düştü.
Sonraki: ders 32, bir MuJoCo görevini RL environment’ı olarak sarmak.
Kaynaklar
- T. Z. Zhao, V. Kumar, S. Levine, C. Finn, “Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware”, 2023. arXiv 2304.13705.
- LeRobot, ACT dokümanı ve
configuration_act.py. - Tüm tablolar:
experiments/31-act/output.txt(27.10.2026).